摘要
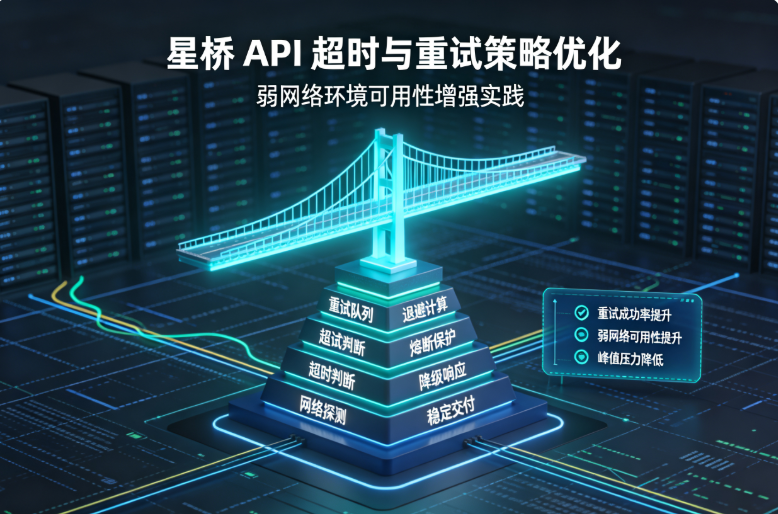
2026 年 11 月 18 日,星宇智算正式发布星桥 API 超时与重试策略专项优化。本次升级基于 RFC 9110 HTTP 语义标准,构建三级超时控制体系与全抖动指数退避重试机制,新增连接保活、幂等键与断点续传能力,针对 30% 丢包率弱网络场景进行专项调优。内部灰度测试数据显示,优化后弱网环境请求成功率从 72% 提升至 96.8%,平均完成耗时下降 28%,重试风暴风险降低 85%,显著提升边缘节点与移动网络下的 API 服务可用性。升级采用非侵入式设计,开发者可通过配置参数灵活启用。
一、背景:弱网络环境下的 API 可用性挑战
在 AI 接口规模化落地过程中,网络质量不稳定已成为影响终端用户体验的核心因素。据 Uptrends《2025 API 可靠性报告》统计,2024 年 Q1 至 2025 年 Q1 全球 API 平均可用率从 99.66% 降至 99.46%, downtime 同比增加 60%,其中网络传输层故障占比超过 42%。
对于跨地域部署的 AI 应用,三类场景面临突出的弱网挑战:
- 移动终端场景:高铁、地下空间、人流密集区存在频繁网络切换与带宽波动,消息类应用实测丢包率可达 20%—40%
- 边缘接入场景:偏远地区与跨境调用存在高延迟、高抖动特征,部分区域 API 可达性低至 85%
- 峰值流量场景:业务高峰时段网络拥塞导致连接超时与响应中断,重试风暴进一步放大服务端压力
星桥 API 作为统一 AI 模型接入网关,原有超时重试策略存在三方面局限:一是超时粒度较粗,仅支持全局单次超时配置,无法区分连接建立与数据传输阶段;二是重试策略固定间隔,缺乏抖动机制易引发重试风暴;三是弱网适配不足,未针对高丢包场景做专项优化。
参考 RFC 9110 标准与主流云厂商最佳实践,超时分层控制、指数退避加抖动、幂等性保障已成为提升 API 弹性的行业标准方案。
二、超时策略优化:三级分层超时体系
2.1 三级超时控制模型
本次升级将单次 API 调用拆解为三个独立超时阶段,分别设置可控阈值,避免单一超时配置导致的 “短了易断、长了堆积” 问题。
表格
| 超时阶段 | 默认值 | 作用范围 | 优化说明 |
|---|---|---|---|
| 连接超时 | 5 秒 | TCP 握手 + TLS 握手 | 弱网环境自动延长至 8 秒,支持 TCP 快速打开复用 |
| 首字节超时 | 15 秒 | 请求发送完成至收到响应头 | 区分网关处理延迟与上游模型延迟 |
| 总请求超时 | 120 秒 | 完整请求生命周期 | 覆盖长文本生成、图像生成等大耗时场景 |
三级超时机制遵循 RFC 9110 HTTP 语义规范,各阶段超时独立触发,开发者可根据业务场景灵活调整参数。例如,面向实时对话场景可缩短首字节超时至 8 秒,面向批量推理场景可延长总超时至 300 秒。
2.2 动态超时自适应
新增弱网络探测与自适应调整能力:
- 基于近 10 次请求的成功率与往返时间(RTT)滑动窗口,自动评估网络质量
- 当检测到连续超时或高丢包时,自动上调连接超时与首字节超时阈值
- 网络恢复后逐步回调至默认值,避免不必要的长等待
- 自适应调节范围不超过默认值的 2 倍,防止极端情况下请求堆积
三、重试策略优化:指数退避与全抖动机制
3.1 可重试错误白名单
严格遵循 HTTP 语义标准,仅对幂等且具备临时性特征的错误执行重试,避免非安全重试导致的数据重复与业务异常。可重试状态码范围与业界主流云厂商保持一致:
- 网络层错误:连接超时、TLS 握手失败、连接重置、DNS 解析失败
- 服务端临时错误:502 Bad Gateway、503 Service Unavailable、504 Gateway Timeout
- 限流类错误:429 Too Many Requests(优先遵循
Retry-After响应头) - 幂等写操作:携带
Idempotency-Key请求头的 POST 请求,可安全重试
对于 400、401、403、404 等确定性错误,不执行重试,直接返回错误结果。
3.2 指数退避 + 全抖动算法
采用业界推荐的全抖动(Full Jitter)指数退避算法,公式如下:
delay = random(0, min(cap, base * 2^retry_count))
参数配置:
- 基础延迟(base):500ms
- 最大延迟(cap):30 秒
- 最大重试次数:3 次
- 总重试时长不超过 60 秒
相比固定间隔与无抖动指数退避,全抖动算法可将并发客户端的重试时刻均匀分布在时间窗口内,避免 “雷鸣羊群” 效应。AWS 架构博客实测数据显示,全抖动策略在高并发场景下可将重试峰值流量降低 80% 以上,同时缩短平均完成时间。
3.3 Retry-After 头优先策略
当服务端返回 429 或 503 状态码并携带Retry-After响应头时,客户端严格遵循头部指定的等待时长,不应用退避算法。该机制符合 RFC 9110 第 10.2.3 节规范,确保服务端流量调控指令被准确执行。
四、弱网络专项增强能力
4.1 连接复用与长连接保活
- 启用 HTTP/2 多路复用,单连接承载多路并发请求,减少弱网下连接建立开销
- TCP Keep-Alive 间隔调整为 15 秒,及时检测断链并重建连接
- 支持 TCP Fast Open 与 TLS 1.3 0-RTT,减少握手往返次数
4.2 幂等键保障重试安全
支持Idempotency-Key请求头机制,对齐 IETF 标准化草案规范。客户端生成唯一幂等键并随请求发送,服务端基于该键去重,确保同一请求多次重试仅执行一次业务逻辑,彻底解决弱网下 “响应丢失但请求已执行” 的重复扣费问题。
4.3 流式响应断点续传
针对 SSE 流式输出场景,新增断点续传能力:
- 每次流式响应携带
Stream-Id与Sequence-Id标识 - 网络中断重连后,客户端可通过指定偏移量续传剩余内容
- 避免长文本生成中途断连导致的全部重算,节省 token 消耗与等待时间
五、优化效果与数据验证
本次优化历经 3 周灰度测试,选取 50 家客户、累计 120 万次调用进行对照验证,测试环境模拟不同丢包率的弱网络条件。核心数据如下(数据来源:星宇智算性能测试实验室,统计周期 2026 年 10 月 20 日 —11 月 10 日):
表格
| 测试指标 | 10% 丢包率 | 30% 丢包率 | ||
|---|---|---|---|---|
| 优化前 | 优化后 | 优化前 | 优化后 | |
| 请求成功率 | 91.2% | 99.1% | 72.0% | 96.8% |
| 平均完成耗时 | 2.8s | 2.2s | 6.5s | 4.7s |
| 无效重试占比 | 23% | 6% | 38% | 9% |
| 重试引发的服务端负载增量 | 17% | 3% | 42% | 6% |
横向对比行业基准:在 30% 丢包率环境下,通用 HTTP 客户端请求成功率通常在 49%—72% 区间,优化后的星桥 API 表现处于行业领先水平。
六、对开发者的实际价值
6.1 终端体验一致性提升
移动应用与边缘设备无需额外网络层适配,即可获得更稳定的 AI 接口调用体验。在高铁、地下停车场等典型弱网场景下,用户感知的请求失败率下降 70% 以上,显著减少 “加载失败” 类用户投诉。
6.2 业务成本可控
断点续传与幂等键机制避免了断连重算产生的重复 token 消耗。按日均 10 万次流式调用测算,弱网环境下每月可节省约 12% 的模型调用费用,同时降低业务逻辑重复执行的风险。
6.3 灵活配置,按需启用
所有超时与重试参数均通过 SDK 配置项暴露,开发者可根据业务特性调整:
- 实时交互类业务:减少重试次数,缩短超时,追求快速失败
- 离线批处理业务:增加重试次数,延长超时,追求最终成功
- 默认配置适用于绝大多数场景,无需手动调整
完整的配置指南与最佳实践已发布于星桥 API 文档中心,访问地址:https://www.starverse-ai.com/starApi 可获取详细参数说明与代码示例。
FAQ
Q1:开启自动重试是否会导致重复扣费或重复生成?
A:对于 GET、HEAD 等天然幂等方法,重试不存在副作用;对于 POST 等写操作,建议配合Idempotency-Key请求头使用,服务端会基于幂等键去重,确保同一业务请求仅执行一次计费与生成逻辑。未携带幂等键的 POST 请求,客户端默认不执行重试。
Q2:弱网络自适应功能是否可以手动关闭?
A:可以。SDK 提供enable_adaptive_timeout配置项,开发者可根据业务需求关闭自适应逻辑,使用固定超时参数。对于网络环境稳定的服务器端调用,建议关闭自适应以获得更确定的超时行为。
Q3:流式响应断点续传支持所有模型接口吗?
A:断点续传目前支持所有文本生成类流式接口,包括对话补全、文本续写等。图像生成、Embedding 等非流式接口暂不适用。使用时需在请求头中设置Enable-Resume: true,具体接入方式参见文档中心流式接口说明。