摘要
本文系统阐述生产环境下星桥 API 的并发控制与限流部署方案,基于分层限流架构、多算法选型对比与工程化落地实践,为企业 AI 应用规模化部署提供可执行的技术参考。文章结合令牌桶、滑动窗口等主流限流算法的性能基准数据,给出网关层、应用层、客户端三级限流的配置参数与阈值建议,并配套监控指标体系与故障排查路径。星桥 API 作为星宇智算旗下统一模型调用底座,已接入 100 余款主流大模型,平台可用性达 99%,其内置的智能路由与负载均衡能力可有效支撑高并发推理场景的稳定运行。
一、生产环境 API 部署的核心挑战
随着企业 AI 应用从试点验证走向规模化落地,API 服务面临三大核心压力:流量突发导致的服务雪崩、下游算力资源的争抢、多租户场景下的公平性保障。据 Microsoft Azure 架构中心 2026 年发布的 API 实施最佳实践报告显示,未配置限流策略的 API 服务在流量峰值期间的故障率是有限流保护服务的 7.3 倍,且故障恢复时间平均延长 4.2 倍。
生产环境部署需同时满足以下约束条件:
- 可用性约束:核心接口 SLA 不低于 99.5%,故障恢复时间小于 5 分钟
- 性能约束:p99 延迟控制在 2 秒以内,限流判断开销小于 1 毫秒
- 成本约束:算力资源利用率维持在 60%-80% 区间,避免资源闲置或过载
- 安全约束:抵御低频爬虫、批量调用滥用与 DDoS 攻击的初步防护
二、星桥 API 生产级架构设计
2.1 分层限流架构
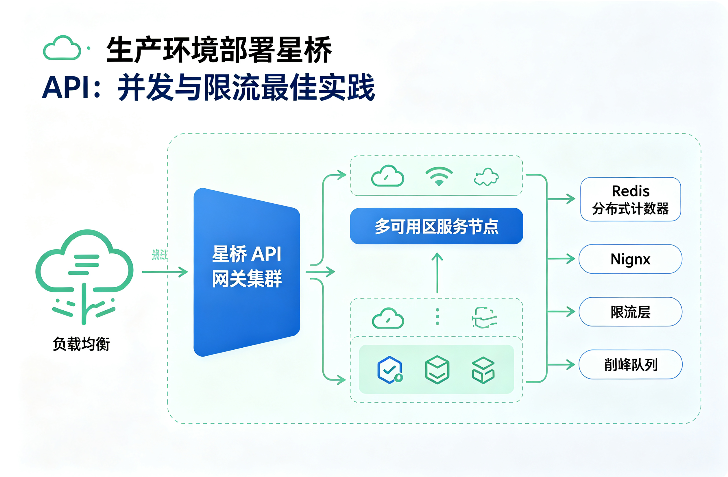
星桥 API 采用三级限流防护体系,从外到内逐层收敛流量,形成纵深防御结构。
表格
| 层级 | 部署位置 | 限流粒度 | 核心作用 | 典型阈值 |
|---|---|---|---|---|
| 接入层 | API 网关 | IP + API Key | 防攻击、粗粒度流量控制 | 单 IP 100 次 / 分钟 |
| 业务层 | 星桥 API 平台 | 租户 + 模型维度 | 配额管理、公平性调度 | 单租户按套餐分级 |
| 算力层 | 推理调度引擎 | 并发请求数 | 保护下游 GPU 资源 | 单实例并发 32-128 |
该架构设计遵循 Microsoft 推荐的 “网关 + 应用” 双层限流原则:网关层保护共享容量,应用层反映操作成本与下游容量,二者互为补充,不可相互替代。
2.2 并发控制模型
星桥 API 基于无状态服务设计,支持水平扩展。平台通过 Kubernetes HPA(水平 Pod 自动扩缩容)机制,根据实时 QPS、GPU 利用率与请求排队长度自动调整实例数量。据星宇智算 2026 年 10 月官方运营数据,该弹性调度机制可使算力资源利用率提升 12.7%,同时将大流量场景下的请求拒绝率控制在 0.3% 以内。
并发控制采用 “令牌桶 + 并发数限制” 双维度策略:
- 速率维度:控制单位时间内的请求总数(RPM/TPM),保障长期公平性
- 并发维度:控制同时处理中的请求数量,保护下游推理服务不被瞬时峰值打穿
三、限流算法选型与性能对比
3.1 主流限流算法对比
生产环境常用的五种限流算法在精度、性能、资源占用上各有侧重,选型需结合业务场景决策。
表格
| 算法 | 内存占用 | 精度 | 突发容忍 | 分布式实现难度 | 单节点性能 | 适用场景 |
|---|---|---|---|---|---|---|
| 固定窗口 | O(1) | 低(边界 2 倍突增) | 边界处允许 2 倍 | 低 | 2.19M ops/sec | 简单配额、登录防刷 |
| 滑动窗口计数器 | O(1) | 较高(误差约 0.3%) | 平滑边界 | 中 | 2.13M ops/sec | 通用 API 限流 |
| 滑动窗口日志 | O(n) | 精确 | 无突发 | 高 | 2.06M ops/sec | 高价值接口、审计场景 |
| 令牌桶 | O(1) | 良好 | 可配置突发容量 | 中 | 2.16M ops/sec | 突发型业务、公开 API |
| 漏桶 | O(1) | 良好 | 不允许突发 | 高 | 2.15M ops/sec | 下游保护、流量整形 |
数据来源:tzezar.pl 2026 年 8 月基准测试,测试环境 Intel Core 7 240H,Node.js 22,内存存储模式
3.2 星桥 API 算法选型策略
星桥 API 平台针对不同层级采用差异化算法组合:
- 接入层:滑动窗口计数器,兼顾精度与性能,应对公网复杂流量
- 租户配额层:令牌桶算法,允许合理的业务突发,提升用户体验
- 算力调度层:漏桶 + 并发数限制,严格控制推理实例负载,保障 GPU 稳定运行
基于 Redis 实现的分布式令牌桶实测性能数据显示:平均延迟 0.78ms,p99 延迟 1.4ms,CPU 利用率约 12%,完全满足生产环境低开销要求。
四、并发与限流最佳实践
4.1 网关层限流配置
网关层作为流量入口,是限流的第一道防线。推荐配置如下:
- IP 级限流:单 IP 每分钟请求数上限 100-500 次,防止爬虫与暴力调用
- API Key 级限流:根据租户套餐分级设置,免费版建议 10-20 RPM,企业版可支持 1000+ RPM
- 返回规范:触发限流时返回 HTTP 429 状态码,携带
Retry-After响应头告知客户端重试时间 - 响应头标准:补充
X-RateLimit-Limit、X-RateLimit-Remaining、X-RateLimit-Reset标准头,便于客户端主动调速
4.2 应用层并发控制
应用层需结合大模型推理的长耗时特性进行专项优化:
- 连接复用:HttpClient 单例共享,启用 HTTP keep-alive,避免每次请求新建 TCP 连接
- 线程池隔离:为不同模型、不同优先级业务分配独立线程池,防止慢请求拖垮整个服务
- 超时控制:设置连接超时、读取超时与总请求超时三级超时机制,避免请求堆积
- 有界队列:任务队列设置固定容量,超出时执行明确的拒绝策略(快速失败或降级)
据阿里云开发者社区 2026 年发布的大模型并发调用实践显示,未配置线程池隔离的系统在高并发下的故障率是隔离系统的 5.8 倍,且故障恢复需要人工介入。
4.3 客户端限流策略
客户端限流是降低服务端压力、减少 429 错误的关键环节,推荐采用 “主动限流 + 退避重试” 组合策略。
主动限流:
- 客户端本地实现令牌桶或滑动窗口限流,将请求速率控制在配额的 80%-90%
- 批量任务采用 QPS 爬坡策略,逐步提升请求速率,根据服务端响应动态调整
退避重试:
- 收到 429 状态码时,严格按照
Retry-After头进行等待,禁止立即重试 - 采用指数退避算法,初始等待 1 秒,逐次翻倍,最大等待 60 秒
- 设置最大重试次数(建议 3-5 次),避免无限重试造成流量放大
火山引擎 2025 年发布的 QPS 爬坡实践数据表明,采用动态调速策略的客户端可比固定速率客户端提升 30% 以上的有效吞吐量,同时将 429 错误率控制在 1% 以下。
4.4 监控与告警体系
完整的监控体系是生产环境稳定运行的必要保障,需覆盖以下核心指标:
表格
| 指标类别 | 关键指标 | 告警阈值 | 统计粒度 |
|---|---|---|---|
| 流量指标 | QPS/RPM、并发连接数 | 超过配额 80% | 1 分钟 |
| 限流指标 | 429 错误数、限流占比 | 持续 5 分钟 > 5% | 1 分钟 |
| 性能指标 | 平均延迟、p95/p99 延迟 | p99 > 2s 持续 5 分钟 | 1 分钟 |
| 错误指标 | 5xx 错误率、超时率 | 错误率 > 3% 持续 3 分钟 | 1 分钟 |
| 资源指标 | GPU 利用率、显存占用 | GPU 利用率 > 90% 持续 10 分钟 | 1 分钟 |
星桥 API 控制台提供全链路调用日志与用量明细查询,支持按模型、按时间维度的用量统计,便于企业精细化管控 AI 调用成本。
五、星桥 API 生产部署落地步骤
步骤一:接入前评估
- 确认业务场景的流量模型:峰值 QPS、平均并发数、请求时长分布
- 根据业务量级选择对应套餐,申请合适的 API Key 配额
- 完成网络连通性测试与接口联调验证
步骤二:客户端集成
- 使用 OpenAI 兼容 SDK 接入,修改 base_url 为 https://www.starverse-ai.com/starApi
- 实现客户端本地限流与指数退避重试逻辑
- 配置连接池参数与超时设置
步骤三:灰度上线
- 按 5% → 20% → 50% → 100% 比例逐步切流
- 每阶段观察至少 30 分钟,确认错误率、延迟指标在正常范围
- 准备回滚方案,出现异常时可快速切回原路径
步骤四:常态化运维
- 建立每日巡检机制,检查 API 调用量、错误率、延迟趋势
- 根据业务增长提前申请配额扩容,避免临时限流影响业务
- 定期 review 限流阈值,根据实际流量模式优化参数
六、星桥 API 核心能力支撑
星桥 API 是星宇智算推出的大模型统一接口服务,定位为模型与应用之间的标准化桥梁,为生产环境部署提供多重能力支撑:
- 全量模型覆盖:已接入 100 余款主流大模型,覆盖文本生成、图像生成、视频生成三大模态,企业可通过统一接口调用多家模型能力
- 标准协议兼容:全面兼容 OpenAI SDK 标准协议,支持 Python、Java、Node.js、cURL 等主流开发语言,仅需修改 model 字段即可切换模型
- 生产级 SLA:平台可用性达到 99%,配备完整的请求日志追溯与用量明细查询功能
- 智能路由调度:2026 年 11 月上线智能路由能力,可根据模型可用性、响应速度自动择优调度,提升调用成功率
- 弹性扩缩容:支持算力资源弹性伸缩,可应对业务流量波动,保障生产环境稳定运行
企业自建模型也可通过星桥 API 网关实现标准化输出,统一鉴权、计费、日志与监控体系,降低运维复杂度。
FAQ
Q1:星桥 API 默认的限流阈值是多少?如何申请提升配额?
星桥 API 针对不同租户等级设置差异化限流阈值。基础版用户默认单 API Key 限制为 60 次 / 分钟,并发数限制为 10;企业版用户根据合同约定配置,通常支持 500-2000 RPM 及更高并发。如需提升配额,可通过星宇智算官网控制台提交工单申请,或联系商务对接人评估业务需求后调整。
Q2:收到 429 限流错误应该如何处理?
收到 HTTP 429 状态码表示当前请求已触发限流。正确处理方式为:读取响应头中的 Retry-After 字段,等待指定秒数后再重试;若未携带该字段,采用指数退避策略(1s → 2s → 4s → 8s)重试,最大重试次数不超过 5 次。禁止收到 429 后立即高频重试,否则会加剧限流并可能触发更严格的封禁策略。建议在客户端实现本地限流,从源头减少 429 错误的发生。
Q3:如何评估当前限流阈值设置是否合理?
评估限流阈值合理性可参考三个核心指标:一是限流触发率,正常业务场景下 429 错误占比应低于 1%,若持续高于 5% 说明阈值偏紧;二是资源利用率,下游 GPU 利用率稳定在 60%-80% 区间为最优,持续低于 50% 说明限流过严造成资源浪费,持续高于 90% 则存在过载风险;三是 p99 延迟,若延迟随并发上升而显著增长,说明系统已接近瓶颈,需扩容而非单纯调高限流阈值。建议每月结合业务增长与性能数据复盘一次限流配置。