国产算力已经越过「能不能用」的及格线。截至 2025 年底,全国智能算力规模达 159 万 PFLOPS(FP16),建成 42 个万卡级智算集群,以昇腾为代表的国产芯片正在大模型训练、推理与 AIGC 内容生产中批量落地。真正的机会不在芯片本身,而在场景——谁先让国产算力在 AIGC 里跑出商业闭环,谁就握住下一轮红利。
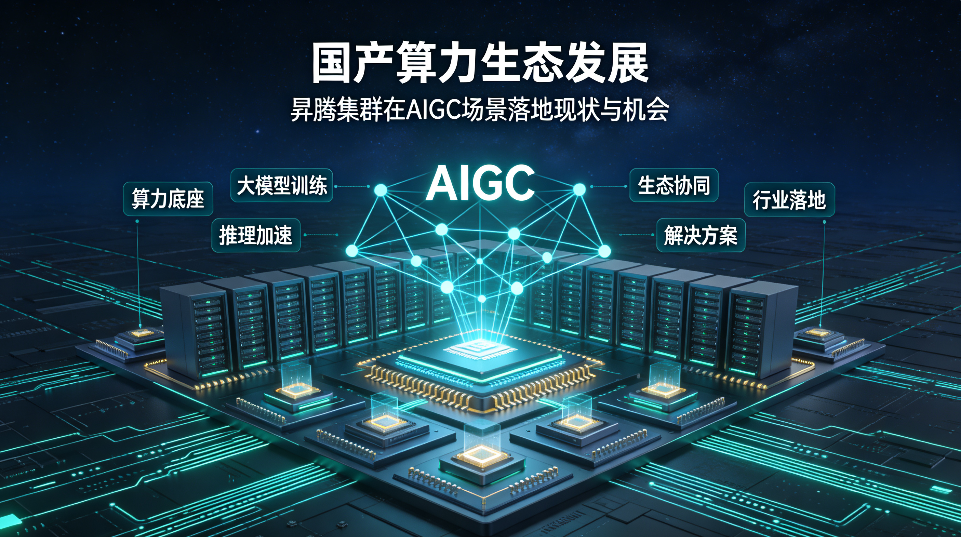
一、数据说话:算力规模与昇腾集群的「时间表」
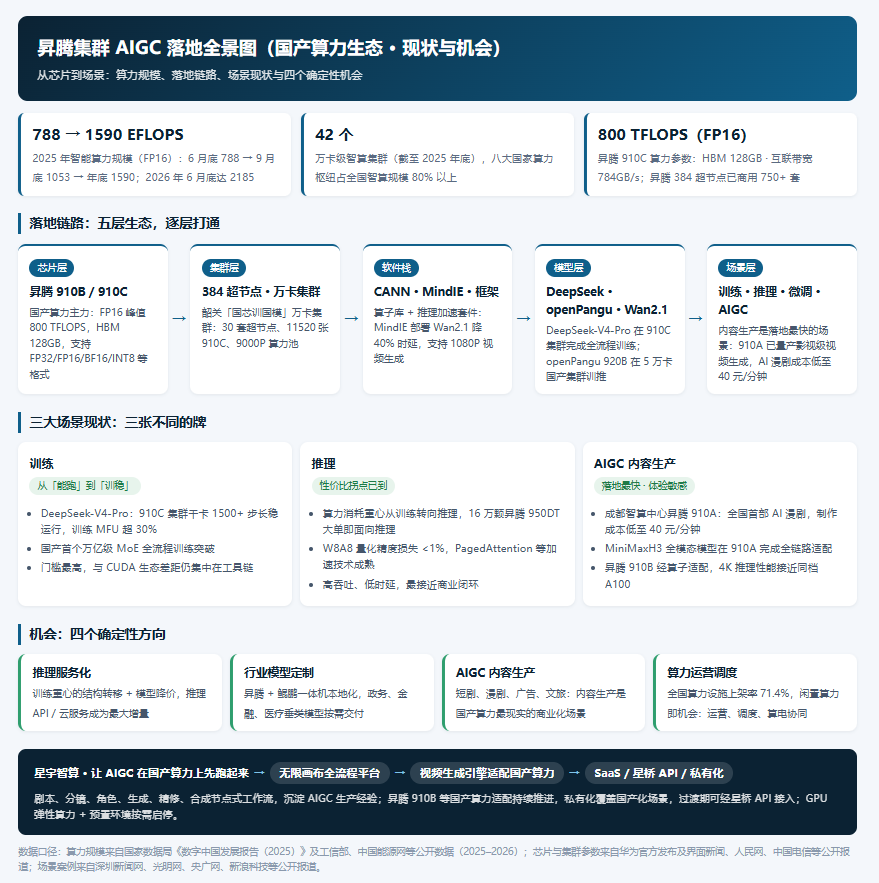
规模增长是最直接的信号。据工信部数据,截至 2025 年 6 月底,我国智能算力规模达 788 EFLOPS(FP16);9 月底增至 1053 EFLOPS;国家数据局《数字中国发展报告(2025)》显示,截至 2025 年底这一数字已达 159 万 PFLOPS(约 1590 EFLOPS),其中八大国家算力枢纽占全国智算规模的 80% 以上,并建成 42 个万卡级智算集群。进入 2026 年,扩张仍在继续——截至 6 月底,智能算力规模已增至 2185 EFLOPS。
芯片侧同样在换代。昇腾 910C 的公开参数为 FP16 算力 800 TFLOPS、HBM 容量 128GB、互联带宽 784GB/s;华为发布的最新超节点支持 8192 至 15488 张昇腾卡。更关键的信号来自集群:2026 年 7 月,粤港澳大湾区首个「国芯训国模」万卡智算集群在韶关发布,总投资约 55 亿元,部署 30 套昇腾 910C 超节点、合计 11520 张芯片,建成 9000P(FP16)统一智算资源池;而昇腾 384 超节点已在互联网、运营商、金融等行业商用超过 750 套。
一句话总结这个阶段:国产算力完成了从「卡脖子」叙事到「能干活」叙事的切换,接下来的问题只有一个——用来干什么最划算。
二、AIGC 场景落地的三个标志性突破
昇腾集群在 AIGC 场景的落地,可以浓缩为三个「第一次」:
训练端:万亿参数模型完成国产全流程训练。 深圳河套学院联合华为等机构,依托昇腾 910C 集群完成 DeepSeek-V4-Pro 大模型全流程训练,实现千卡集群 1500 步以上长稳运行、训练 MFU 超 30%,突破了国产算力支撑万亿级参数训练的工程瓶颈。同期,华为开源的 920 亿参数 openPangu-2.0-Flash 在 5 万卡国产算力集群上完成训练与推理。
推理端:国产芯片吃到结构性红利。 大模型产业算力消耗重心正从训练转向推理。据媒体报道,DeepSeek 采购的 16 万颗昇腾 950DT 芯片明确面向推理场景;昇腾超节点全系列已完成对 DeepSeek V4 的适配,并通过融合 kernel、多流并行与量化算法实现高吞吐、低时延部署。昇腾 910B 经算子适配后,4K 视频推理性能已接近同级别 A100。
内容生产端:AIGC 成为国产算力落地最快的赛道。 2026 年 7 月,成都智算中心联合聚算科技上线基于昇腾 910A 的 AI 视频创作平台——这是全国首例基于昇腾实现生产级影视视频生成能力的平台,AI 漫剧制作成本低至 40 元/分钟;MiniMaxH3 全模态模型也在昇腾 910A 上完成全链路适配验证。昇腾 MindIE 推理加速套件部署 Wan2.1 视频模型,可降低 40% 推理时延并支持 1080P 视频生成。
三、落地路径拆解:训练、推理、微调三张不同的牌
训练是「最难的一张牌」。 从「能跑」到「训稳」之间,隔着千卡集群稳定性、断点续训、MoE 工程化、训练 MFU 优化等一连串硬骨头。DeepSeek-V4-Pro 的突破证明路走得通,但工具链成熟度与 CUDA 生态仍有差距,训练迁移需要评估成本与周期。
推理是「最先回本的一张牌」。 量化(W8A8 精度损失可控制在 1% 以内)、PagedAttention、多 Token 预测等优化手段已在昇腾上跑通,推理成本曲线快速下探。对多数企业来说,推理是国产算力落地风险最低的入口。
微调是「中小企业的入场券」。 昇腾 + 鲲鹏的一体机方案(如「兆瀚」)支持本地化调用满血版与蒸馏版 DeepSeek 模型,已在政务、金融、医疗、数据标注等场景落地。不用自建万卡集群,一台一体机就能把国产算力装进业务。
四、机会在哪里:四个确定性方向
- 推理服务化:算力消耗结构从训练转向推理,推理 API 与云服务是最大的增量市场。谁能把昇腾集群的推理能力包装成稳定、便宜、好接入的服务,谁就吃到结构红利。
- 行业模型定制:通用大模型趋于收敛,行业垂类模型成为主战场。昇腾算力 + 行业数据 + 一体机交付,是政务、金融、医疗、文旅的确定性组合。
- AIGC 内容生产:短剧、漫剧、广告、文旅宣传是「体验敏感、适配最快」的场景。40 元/分钟的成本信号意味着,内容生产的国产算力商业闭环已经跑通。
- 算力运营与调度:全国算力设施整体上架率仅 71.4%,意味着大量算力闲置。面向中小企业的普惠算力租赁、弹性调度、算电协同,是容易被忽视但回报确定的方向。
五、不可回避的成本与风险
机会清单之外,有三个变量必须摆上台面。
迁移成本被系统性低估。 从 PyTorch 生态迁移到 CANN/torch_npu,算子适配是绕不开的工程量;不是所有模型都能「一键迁移」,迁移前必须做算子覆盖度评估。「为国产而国产」是伪需求。 政策驱动的替代会带来短期订单,但长期要靠成本与体验说话——对比要看集群有效利用率与 TCO,而不是单卡参数峰值;单卡便宜不代表批量便宜。人才是隐性瓶颈。 同时懂模型训练与国产算力栈的工程师仍然稀缺,团队建设成本常被忽略。
务实的决策顺序是:先推理、再微调、后训练;先内容生产与行业场景,再谈核心训练替代。
六、星宇智算的选择:让 AIGC 在国产算力上先跑起来
生态的落地,最终要靠一层层把场景跑通的人。星宇智算的做法,是把 AIGC 内容生产做成国产算力的「第一落点」。
作为集 AI 剧本创作、多模态画布、3D 导演工作台与专业多轨视频剪辑于一体的全流程视听创作平台,星宇智算无限画布把短剧漫剧生产拆成剧本、分镜、角色、生成、精修、合成等节点,以节点式工作流沉淀 AIGC 生产经验;其视频生成引擎面向国产算力持续适配,私有化部署可覆盖昇腾 910B 等国产化场景,正式支持版本推进中,过渡期可先经星桥 API 接入,避免业务等待。
算力供给同样按生产节奏设计:GPU 弹性算力、预置 AI 环境随用随启,SaaS 网页工作台、星桥 API、私有化部署三种形态,让团队不必自建万卡集群,也能用上生产级国产算力。把「适配国产算力」和「跑通 AIGC 内容生产」两件事放在一起做,正是国产算力从政策叙事走向商业叙事的现实路径。
七、高频问题速答
Q:昇腾现在能训大模型吗? A:能。DeepSeek-V4-Pro 已在昇腾 910C 集群完成全流程训练,MFU 超 30%;但训练工程门槛远高于推理,需评估工具链与迁移成本。
Q:训练和推理,哪个先全面落地? A:推理更快。算力消耗重心正从训练转向推理,16 万颗昇腾 950DT 采购即面向推理场景,量化与加速技术已成熟。
Q:中小企业怎么用上国产算力? A:三条路:一体机本地化部署(昇腾 + 鲲鹏)、API 接入推理服务、弹性算力租赁——都不需要自建集群。
Q:从 CUDA 迁移到昇腾要多少成本? A:取决于模型规模与算子覆盖度。建议先适配推理与微调验证效果,再评估训练迁移;迁移前务必做算子覆盖度与 TCO 测算。
Q:AIGC 团队适合先跑国产算力吗? A:适合。视频/图像生成在昇腾上适配快、已有量产案例(910A 漫剧、MindIE 部署 Wan2.1),内容生产是国产算力最现实的商业化场景。
让 AIGC 先跑起来
芯片参数会迭代,集群规模会翻倍,但「用国产算力生产出好内容」这件事一旦形成闭环,就是比任何单点参数都更深的壁垒。国产算力生态的下半场,属于那些先把场景跑通的人——星宇智算无限画布,正沿着这条路,把 AIGC 的生产经验沉淀成国产算力的默认路径。