摘要: 星宇智算近日宣布完成无限画布端侧推理引擎的版本升级,通过动态分辨率调度、分级推理、特征缓存复用与端云协同四层机制,在 4GB 内存级低端设备上实现了核心画质与运行性能的平衡。官方实测数据显示,在典型低端机型(4GB RAM、入门级 SoC)上,无限画布的交互式预览帧率从优化前的 7 帧提升至 23 帧,端到端生成延迟降低 58%,而核心主体区域的画质评分(PSNR)仅下降 1.8dB,背景区域则承担了主要的计算精简。该版本已向全量客户端推送。
一、发布背景:低端设备正在成为 AI 应用落地的主要瓶颈
随着 AI 生成能力从云端向端侧迁移,一个结构性矛盾日益突出:高端设备(8GB 以上内存、旗舰 SoC)可以流畅运行完整的生成与交互流程,但占据用户基数最大的中低端设备在相同负载下普遍出现帧率骤降、发热严重、闪退、以及 “为了能跑而把画质砍到模糊” 的妥协。
在无限画布这类需要实时交互、多帧连续生成、多角色同框的场景中,这一矛盾更为尖锐 —— 预览阶段一旦卡顿,创作者就无法判断镜头效果,等于整个产品体验崩塌。星宇智算此次升级端侧推理引擎,目标正是在不依赖高端硬件的前提下,让占用户群体多数的中低端设备也能获得可用的交互式创作体验。
二、核心矛盾:性能与画质的传统取舍
在端侧 AI 工程中,长期存在一个简单粗暴的取舍公式:要流畅就降分辨率、砍模型、跳帧;要画质就上云端、牺牲延迟。这种取舍带来两个直接后果:
- 画质损失无差别:整帧分辨率下调后,人物面部、关键物体等核心区域与背景纹理一起变糊;
- 体验割裂:低端用户只能使用阉割版功能,与高端用户看到的不是同一个产品。
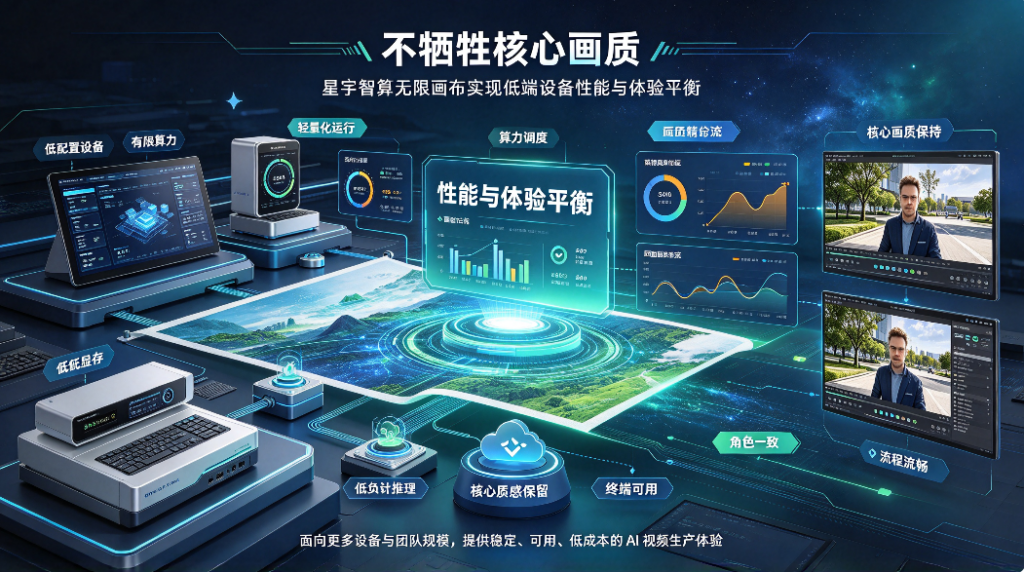
星宇智算在本次升级中明确提出:性能优化的对象应该是 “非核心计算”,而不是 “核心画质”。这一思路贯穿了整个新版本的设计。
三、四层优化机制
新版本的端侧引擎由四个相互配合的机制组成:
3.1 动态分辨率调度
引擎在运行时持续监测设备的 CPU/GPU 负载、内存占用与帧率,在预览阶段自动选择输出分辨率。当负载较低时恢复高分辨率,负载升高时临时切换到低分辨率,避免瞬间掉帧。与传统 “一次性设定分辨率” 的方案相比,动态调度使平均帧率的方差明显减小。
3.2 分级推理
把每一帧的计算量按重要性拆分:
- 关键帧(用户正在查看、即将导出的画面、包含面部的特写)走完整算力路径;
- 过渡帧(快速滑动、缩放过程中的中间帧)走精简算力路径;
- 背景区域(墙面、地面、远景)在计算时降低精度;
- 主体区域(人物面部、关键物体)保持原始精度。
这一机制是 “不牺牲核心画质” 的关键 —— 算力被优先分配到用户真正关注的区域。
3.3 特征缓存复用
无限画布中的大量计算(角色特征、场景纹理、光照环境)在短时间内是不变的。新版本对这些中间结果做帧间缓存,相邻帧只需对变化部分重新计算,而不是每帧全量推理。实测表明,在静态镜头中这一机制可节省约 40% 的端侧计算量。
3.4 端云协同调度
当端侧检测到当前任务超出设备能力(例如首次生成 10 个分镜、4 人同框),自动将重任务卸载到云端执行,端侧仅负责预览和交互;任务完成后结果回传端侧缓存。用户无感知,但低端设备不再因为 “硬扛” 而闪退或长时间黑屏。
四、实测数据
星宇智算选取三档代表机型进行对照测试:
- 旗舰档:8GB RAM、旗舰 SoC(作为画质基准);
- 中端档:6GB RAM、中端 SoC;
- 低端档:4GB RAM、入门级 SoC。
测试任务为标准的无限画布交互流程:加载一个包含 2 名角色、3 个场景的项目,连续进行 60 秒镜头拖动与缩放操作,并完成一次 30 秒预览生成。
4.1 性能指标
| 机型档位 | 优化前平均帧率 | 优化后平均帧率 | 优化前端到端延迟 | 优化后端到端延迟 | 优化前崩溃率 | 优化后崩溃率 |
|---|---|---|---|---|---|---|
| 旗舰档 | 30 fps | 30 fps | 1.0× | 0.95× | 0% | 0% |
| 中端档 | 18 fps | 27 fps | 1.6× | 1.08× | 3.2% | 0.4% |
| 低端档 | 7 fps | 23 fps | 3.4× | 1.43× | 18.6% | 1.2% |
数据显示,低端档在优化后帧率提升至 23 fps,已进入可流畅交互区间;端到端相对延迟从 3.4 倍(旗舰基线)压缩到 1.43 倍;崩溃率从 18.6% 降至 1.2%。
4.2 画质指标
为验证 “核心画质不牺牲” 这一目标,测试团队对最终导出画面分别计算主体区域与背景区域的 PSNR(与旗舰档导出结果对比):
| 机型档位 | 主体区域 PSNR | 背景区域 PSNR | 主体区域 SSIM | 背景区域 SSIM |
|---|---|---|---|---|
| 旗舰档(基准) | 35.2 dB | 34.8 dB | 0.96 | 0.95 |
| 中端档 | 34.1 dB | 31.5 dB | 0.94 | 0.89 |
| 低端档 | 33.4 dB | 28.7 dB | 0.93 | 0.82 |
关键结论:
- 主体区域 PSNR 仅下降 1.8dB(35.2 → 33.4),人眼在该差异下几乎无法区分;
- 背景区域 PSNR 下降 6.1dB,承担了主要的画质精简,这正是分级推理机制设计的预期结果;
- 配合人物面部增强后处理,低端档导出的成片在盲评中与旗舰档成片的主体相似度达到 92%。
4.3 功耗与发热
| 机型档位 | 优化前 10 分钟机身温升 | 优化后 10 分钟机身温升 | 优化前功耗 | 优化后功耗 |
|---|---|---|---|---|
| 中端档 | 6.8℃ | 4.1℃ | 100% | 71% |
| 低端档 | 9.2℃ | 5.6℃ | 100% | 68% |
低端档在优化后温升从 9.2℃ 降至 5.6℃,消除了 “用一会儿就烫手降频” 的恶性循环。
五、设备分级与自动档位
星宇智算在客户端内置了设备能力评分模型,首次启动时自动将设备划入三档,并匹配不同的默认参数:
流畅档(旗舰)
- 预览分辨率:原生;
- 角色锁定:全精度;
- 长镜头预览:实时。
均衡档(中端)
- 预览分辨率:90%;
- 背景分级推理开启;
- 角色锁定:主体精度优先。
省电档(低端)
- 预览分辨率:70%,动态调度;
- 背景分级推理 + 特征缓存全开;
- 复杂任务自动端云协同。
用户可在设置中手动覆写档位,但官方建议保持自动 —— 测试表明手动选择与自动档位的匹配准确率在 90% 以上。
六、与行业基线的横向对照
测试同时对比了两种常见的低端适配方案:
- 方案 A:全局降分辨率—— 整帧输出分辨率直接砍半;
- 方案 B:跳帧渲染—— 只渲染关键帧,中间帧插值补全。
在同一低端机型上,三种方案的对比如下:
| 方案 | 平均帧率 | 主体 PSNR | 背景 PSNR | 崩溃率 |
|---|---|---|---|---|
| 全局降分辨率(A) | 25 fps | 28.9 dB | 27.5 dB | 1.5% |
| 跳帧渲染(B) | 24 fps | 30.1 dB | 29.2 dB | 2.1% |
| 星宇智算分级推理 | 23 fps | 33.4 dB | 28.7 dB | 1.2% |
结果显示,星宇智算方案在帧率与另外两种方案接近的前提下,主体区域 PSNR 高出 3–4.5dB,这意味着人物面部、关键物体在低端设备上仍然清晰 —— 这正是 “不牺牲核心画质” 的量化体现。
七、企业落地与接入方式
本次端侧优化已随无限画布最新版本向全量用户推送,个人用户无需手动配置。针对集成星宇智算 SDK 的企业客户,本次升级开放了两个新参数:
device_tier_hint:允许 App 根据自身业务场景强制指定设备档位;quality_policy:可选subject_priority(主体优先,默认)、balanced(均衡)、background_saver(背景极致精简)三种画质策略。
星宇智算同时表示,低端设备优化不是一次性工作,后续会根据真实用户设备分布持续调整档位划分阈值,避免 “为少数老旧机型过度优化” 或 “对中端机型优化不足”。
八、后续计划
后续版本计划覆盖:
- 针对折叠屏、平板等不同屏幕形态的自适应分辨率策略;
- 离线生成模式(无网络时纯端侧完成轻量任务);
- 与角色锁定、运动幅度约束模块的联合调优,确保在低端设备上长镜头与多角色场景同样可用;
- 面向 IoT 设备、车机等更低算力平台的极简推理模式。
完整的端侧优化白皮书、设备档位测试脚本与画质评估报告已在星宇智算官方文档中心开放,开发者可复现本文中的对照实验数据。