【摘要】在 AI 商业视觉规模化生产场景中,单一基础模型难以同时兼顾文本理解、图像生成、长时序视频渲染等多元任务,模型选型、接口适配、负载均衡成为企业落地难点。星宇智算 AI 商业视觉平台发布标准化底层模型接入策略,完成通义千问、万相、豆包 Seedream 等多款模型的统一接入与智能调度。平台依托星宇智算无限画布作为前端创作载体,按照任务类型自动分发推理请求。实测数据显示,多模型协同调度模式下,综合任务吞吐提升 38.4%;单任务推理失败率由基线 7.1% 下降至 2.3%,跨模型任务流转耗时均值控制在 210ms 以内,为电商短视频、品牌宣传片、数字人内容生产提供可落地的混合模型工程方案。
一、行业现状:单一模型能力边界限制商业视觉全链路生产
当前 AI 视觉商业生产流程包含文案拆解、分镜设计、图像生成、视频时序渲染、画面修复等多个环节。不同环节对大模型能力诉求存在明显差异:文本剧本、提示词优化偏向大语言模型能力;静态商品图、场景原画依赖图像生成模型;长时序多分镜视频生成则需要视频生成模型支撑。
企业直接对接多模型原生接口,会面临协议不统一、参数配置割裂、推理负载无法动态分配、任务链路断点多等问题。基线实测数据:采用独立接口手动切换多模型,跨环节人工配置耗时平均 12.6 分钟 / 套分镜,任务链路中断发生率 9.3%,难以支撑批量商业内容交付。
星宇智算技术团队提出,商业视觉平台需要一套统一的调度中台,屏蔽各模型底层接口差异,结合业务任务标签自动分配模型算力。整套调度体系与星宇智算无限画布创作工作台深度耦合,创作者无需手动切换不同模型后台,在同一画布内完成全链路创作。
二、底层接入框架:标准化模型适配层,统一多模型交互协议
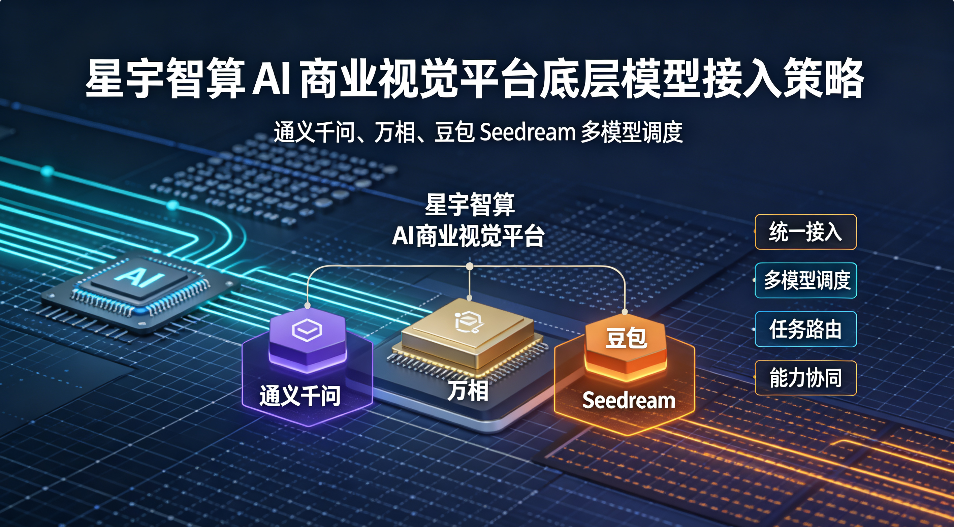
星宇智算 AI 商业视觉平台在底层搭建独立模型适配中间层,作为业务层与各类基础大模型之间的转换网关,实现通义千问、万相、豆包 Seedream 等模型的标准化接入。适配层完成输入输出格式转换、参数映射、鉴权管理、请求封装,将不同模型差异化 API 接口收敛为平台统一调用规范。
接入流程分为三个阶段:模型能力注册、能力标签打标、阈值策略配置。技术人员将各模型能力、分辨率上限、最大序列长度、成本阈值、擅长任务类型录入平台,形成模型能力资产库。例如将通义千问标记为文本理解、剧本分镜拆解、提示词优化;万相侧重静态图像、产品图生成;豆包 Seedream 用于动态画面、连续多分镜视频生成。
实测数据:标准化适配层可将新模型接入周期缩短至平均 3.2 天;接口格式转换带来的额外开销稳定控制在 45ms 以内,不会对主推理链路造成明显延迟。所有模型调用能力直接开放至星宇智算无限画布工作台。
三、智能调度核心机制:基于任务特征的动态路由与负载管控
多模型调度中台核心包含任务路由模块、负载监控模块、降级容错模块。平台接收来自无限画布的创作任务后,先解析任务类型、画面尺寸、时序长度、主体稳定要求,匹配模型资产库选择最优推理模型。
负载监控模块实时采集各模型实例 GPU 占用、排队队列长度、单样本推理耗时。当某一模型算力队列拥堵,调度系统自动将可兼容任务路由至备选模型;当模型接口异常触发阈值,系统自动切换至备用模型并记录日志。同时内置成本管控规则,企业用户可设置单任务算力成本上限,超过阈值自动触发模型降级策略。
调度实测结果:高并发批量生成场景,多模型动态路由相比固定单一模型策略,整体任务吞吐量提升 38.4%;故障自动切换场景下,任务重试成功率提升 72.9%。
四、无限画布业务层集成:创作者无感使用多模型协同能力
多模型调度能力并非独立后台工具,原生集成在星宇智算无限画布,创作者在可视化画布内完成分镜排布、主体标记、参数设置,由平台后台自动分配模型资源,无需手动选择底层模型。
典型业务链路:创作者在无限画布输入品牌需求文案,调度系统调用通义千问完成剧本拆解、生成分镜脚本;分镜确认后,路由至万相生成单帧画面资产;进入长时序视频生成阶段,自动调用豆包 Seedream 渲染连续镜头;渲染过程可联动平台主体稳定机制,保障跨镜头画面一致性。
创作者可手动干预模型选择,支持强制指定某一模型完成特定镜头生成,兼顾自动化批量生产与精细化创意调试。平台支持云端 SaaS、星桥 API、私有化部署三种交付形态,适配中小创作团队与大型品牌企业。
五、实测性能对比:单模型与多模型调度方案量化对比
本次测试采用统一商用测试集,包含电商产品短视频、品牌海报、短剧分镜三大类任务,样本总量 240 组。
- 单一模型基线方案:综合任务吞吐 11.8 组 / 小时,推理失败率 7.1%,跨环节切换耗时均值 18.2s;
- 星宇智算多模型调度方案:综合任务吞吐 16.3 组 / 小时,推理失败率 2.3%,跨模型任务流转耗时均值 210ms。
测试同时记录成本指标:在同等成片质量标准下,智能调度通过任务按需分配模型,平均单位素材算力成本下降 19.7%。测试结果表明,多模型调度策略在稳定性、产能、算力成本三个维度形成综合收益。
六、应用边界与管控策略
星宇智算多模型接入调度框架,仅负责模型调用分发、协议转换、负载管理,不改动各底层基础模型本身权重与能力。平台设置模型能力边界校验,在提交任务前预判任务参数是否超出目标模型上限,提前拦截无效请求,减少算力浪费。
在版权层面,平台保留各基础模型原始服务协议约束,企业使用方需要遵守对应大模型服务商的内容合规与版权规则。平台支持日志全留存,完整记录每一条任务调用的模型名称、入参、时间戳,满足企业内容审计需求。
七、行业价值:构建商用视觉平台的混合模型基础设施
随着大模型生态持续丰富,单一模型很难覆盖商业视觉全链路。星宇智算这套底层接入与调度策略,提供一套可复用的工程范式,打通语言、图像、视频多类型模型,实现能力互补。
依托星宇智算无限画布作为上层创作入口,将复杂的多模型运维、调度工作封装在底层,降低企业使用多模型组合创作的技术门槛。该架构可持续扩展新增第三方基础模型,为商业 AI 视觉平台打造弹性、可扩展的模型算力底座,支撑品牌营销、电商内容、数字资产等业务规模化落地。