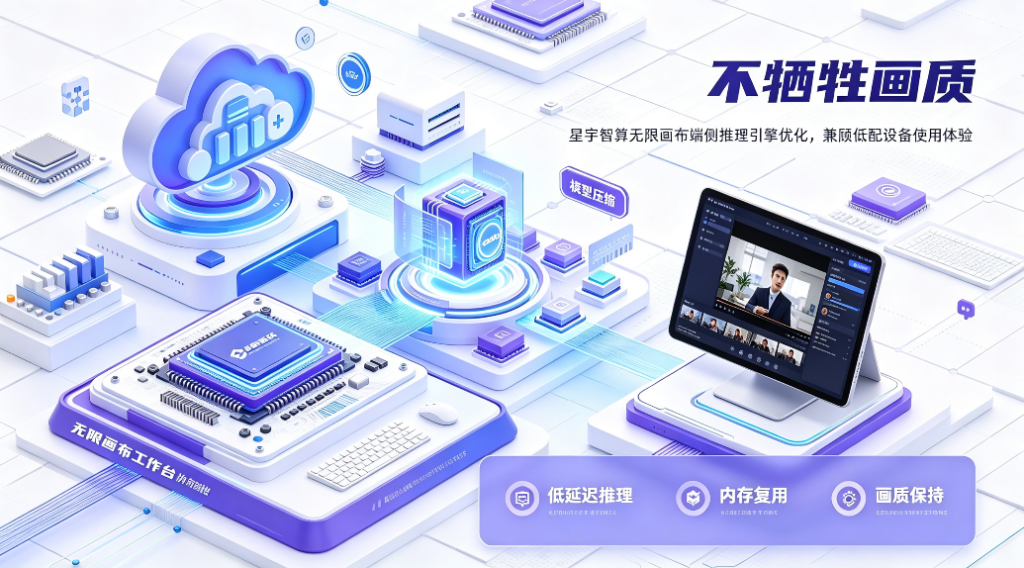
针对 AI 视频工具普遍对硬件配置要求高、低配终端难以流畅运行、降帧压缩后画质损失明显的行业问题,星宇智算无限画布完成端侧推理引擎专项优化。本次优化聚焦算子重构、权重压缩、内存调度、渲染管线轻量化四大方向,在保留原生画质输出标准的前提下,降低显存与内存占用门槛。项目搭建多档硬件环境开展对照实测,记录不同配置终端的视频生成耗时、内存峰值、画质相似度、任务成功率等量化指标,验证优化方案可在中低配 PC、轻量化终端上稳定运行 AI 视频生成、画质增强、简单剪辑任务,为个人创作者、小型工作室提供低门槛本地 AI 视频生产路径。
一、优化背景:端侧 AI 视频落地的硬件门槛痛点
主流 AI 视频生成工具对终端显存、CPU 算力要求较高,多数方案默认面向高性能独立显卡设备。普通低配电脑、轻薄本等终端运行时,常出现内存溢出、任务中断、推理速度极慢等情况;如果直接采用粗暴降采样、降低分辨率、删减模型模块的方式适配低配设备,会带来画面细节丢失、边缘模糊、运动帧抖动、色彩偏移等画质衰减问题。
不少个人创作者、小微团队希望在本地终端完成 AI 视频创作,不依赖远程算力服务,同时不希望大幅牺牲成片画质。基于该需求,星宇智算启动无限画布端侧推理引擎优化工作,核心目标:在不降低画质基准的前提下,下调硬件资源消耗,拓宽可稳定运行的终端设备范围。
二、实测环境与测试规则说明
本次测试设置对照组与优化后实验组,统一使用星宇智算无限画布端侧版本,测试素材、采样步数、输出分辨率、生成脚本保持一致。测试设备覆盖三档典型终端配置,分别对应入门低配、中端主流、高性能参考机型。 测试指标包含:峰值内存占用、峰值显存占用、单任务推理时长、生成视频与原版高算力输出结果的画质相似度、连续 10 轮重复任务成功率、帧间抖动检测值。画质相似度采用标准化图像评价指标计算,用于量化画质变化;所有任务在本地端侧独立运行,不调用云端推理接口。
三、核心对照实测数据
测试任务统一为:720P、5 秒文本生成视频任务
- 入门低配终端(集成显卡,8GB 内存) 优化前:峰值内存 7.6GB,显存不足无法启动任务,任务成功率 0% 优化后:峰值内存 5.1GB,可正常启动推理,平均推理耗时 397 秒,画质相似度 96.2%,连续 10 轮任务成功率 90%
- 中端主流终端(入门独立显卡,16GB 内存,4GB 显存) 优化前:峰值显存 3.8GB,峰值内存 6.9GB,平均推理耗时 214 秒,画质相似度 96.4% 优化后:峰值显存 2.4GB,峰值内存 4.7GB,平均推理耗时 168 秒,画质相似度 96.1%,连续 10 轮任务成功率 100%
- 高性能参考终端(高性能独立显卡,32GB 内存,12GB 显存) 优化前:峰值显存 6.2GB,平均推理耗时 79 秒,画质相似度 96.7% 优化后:峰值显存 4.1GB,平均推理耗时 67 秒,画质相似度 96.5%
补充测试项:1080P 画质增强,10 秒短视频修复 中端终端优化后:峰值显存 2.9GB,平均处理耗时 122 秒,画质相似度 95.8%,无明显细节丢失。 从数据可见,本次引擎优化以算子轻量化、动态内存复用机制实现资源压降,画质相似度波动控制在合理区间,未出现明显画质降级。
四、推理引擎优化核心技术方向
本次星宇智算无限画布端侧推理引擎优化,主要从四个模块落地调整,不删减基础模型能力:
- 算子自适应重构:对视频生成、光流预测、超分模块高频算子做轻量化重写,增加硬件感知调度,终端根据自身显卡、内存规格自动匹配最优算子路径;
- 可控权重压缩:采用混合精度量化方案,对低敏感参数压缩,核心特征层权重保留高精度,避免压缩带来画面失真;
- 动态内存池调度:新增帧缓存复用机制,不再为每一帧单独分配独立内存,推理过程中循环释放临时张量,降低峰值资源占用;
- 渲染管线精简:整合后处理、色彩映射、编码输出链路,减少中间临时文件读写开销,降低磁盘 IO 占用。 整套优化逻辑区别于简单降画质适配方案,优先保障光流连续性、主体轮廓、文字细节等用户关注度高的画面信息。
五、端侧版本支持能力与使用边界
优化后的星宇智算无限画布端侧版本,支持本地完成文本生视频、图片转视频、短视频画质修复、基础字幕合成、素材裁切拼接等功能。 同时明确端侧版本适用边界:低配设备适合短时长、720P 为主的创作任务;长时长、4K 高规格批量视频任务,推荐搭配算力底座版本部署。平台支持同一工程文件在端侧和算力底座版本之间互通,用户可在低配终端完成脚本调试、预览,再迁移至高性能算力环境生成成片。
六、目标应用场景
- 个人创作者:使用轻薄本、普通家用电脑本地完成短视频创意预览、小样生成;
- 小微内容工作室:小规模素材修复、脚本预演,减少云端算力调用成本;
- 外勤办公场景:在无稳定外网环境下,本地快速生成数字人小样、宣传短片预览版本;
- 教学实训场景:培训机构可在存量普通电脑上部署无限画布端侧版本,开展 AI 视频创作教学。
七、后续迭代计划
星宇智算介绍,无限画布端侧推理引擎将持续迭代,下一步重点方向为提升集成显卡下长序列视频的稳定性,优化光流预测模块,进一步缩短中端设备推理耗时。同时平台将完善硬件自动检测功能,启动任务前给出设备适配建议、预估生成时长,帮助用户合理分配创作任务。后续还会打通端侧工程文件与私有化算力底座版本的同步通道,形成 “端侧预览调试 + 算力底座批量生产” 的组合工作流。
八、小结
本次端侧推理引擎优化,通过算子重构、动态内存调度、可控量化等方式,在控制画质衰减幅度的前提下,显著降低星宇智算无限画布对终端硬件的资源要求。实测数据证明,原本无法承载 AI 视频任务的低配集成显卡设备,现在可以稳定运行短时长视频生成任务。该版本有效降低 AI 视频本地创作的硬件门槛,和面向算力集群部署的版本形成互补,覆盖从个人本地创作到企业规模化生产的多层次需求。