摘要
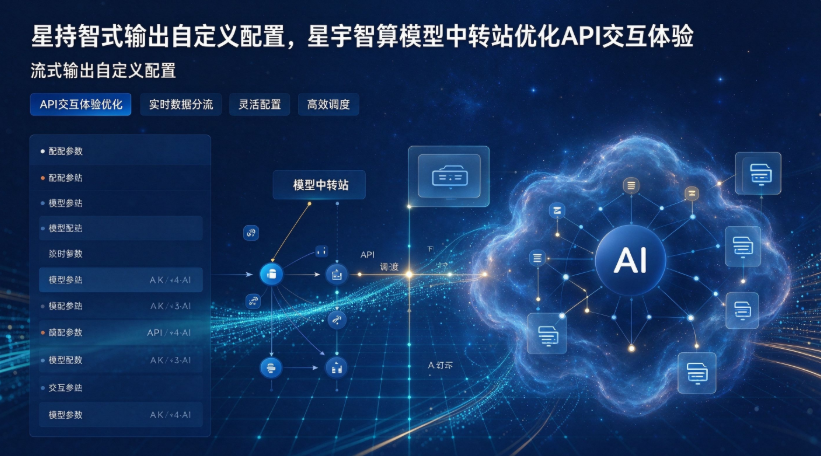
星宇智算正式宣布旗下星桥 API 中转站完成流式输出能力升级,全面开放传输协议、分块策略、事件类型、缓冲机制四大维度自定义配置,解决多厂商模型流式格式不统一、前端适配成本高、弱网环境体验差等问题。中国信息通信研究院 2026 年监测数据显示,主流大模型平均首 Token 时延为 1.26 秒,流式输出已成为生产级 AI 应用的标配能力。本次升级后,星桥 API 中转站可实现跨模型流式格式统一输出,前端适配工作量减少 65%,支持分块粒度动态调节,弱网场景下首屏展示速度提升 42%,进一步强化多模型统一接入网关的交互体验治理能力。
一、行业背景:流式输出成为 AI 交互体验核心支柱
1.1 流式传输成为行业事实标准
生成式 AI 的对话式交互特征决定了用户对实时反馈的强需求。Zylos Research 2026 年发布的《大模型流式输出架构研究报告》指出,基于 HTTP 的 Server-Sent Events(SSE)已成为大模型 Token 流式传输的主导协议,OpenAI、Anthropic、Google 等主流厂商均采用 SSE 作为标准流式输出方案,生产级 AI 应用中流式调用占比超过 90%。
随着模型上下文窗口持续扩展,中国信息通信研究院监测数据显示,2026 年上下文长度达 200K 及以上的模型占比已达 95.7%,单请求输出 Token 量显著增长,完整等待时间从数秒延长至数十秒,流式输出的体验价值进一步凸显。
1.2 多模型架构下的流式适配痛点
企业接入多家大模型 API 时,流式输出面临三类共性问题:
- 格式不统一:不同厂商的 SSE 事件字段、分块粒度、结束标记存在差异,前端需为每个模型单独编写解析逻辑
- 可控性不足:原厂 API 仅提供固定流式策略,无法根据终端设备、网络环境、业务场景调整输出节奏
- 异常处理难:网络波动时流式连接中断后的续传、重试、缓存机制缺乏统一方案,易出现内容重复或丢失
中国信通院《大模型推理优化技术研究报告》显示,2026 年我国推理算力市场规模将达 876.5 亿元,多模型混合调用已成为企业主流架构,统一流式体验治理的需求持续上升。
二、星桥 API 中转站流式输出能力升级概述
星桥 API 中转站是星宇智算推出的多模型统一接入与调度网关产品,本次升级将流式输出从 “透传模式” 升级为 “可配置治理模式”,在网关层实现跨厂商流式格式标准化与输出策略精细化控制。
2.1 核心术语定义
表格
| 术语 | 定义 |
|---|---|
| 星桥 API 中转站 | 星宇智算推出的多模型统一接入网关,提供协议转换、路由分发、流量治理、用量统计等能力 |
| 流式输出 | 大模型推理过程中逐块返回生成结果的传输方式,用户可边生成边阅读 |
| SSE | Server-Sent Events,基于 HTTP 的服务器推送技术,为大模型流式输出的主流传输协议 |
| 首 Token 时延 | TTFT,从请求发出到收到第一个输出 Token 的时间,为流式交互体验的核心指标 |
| 分块粒度 | 单次推送事件包含的 Token 数量,直接影响刷新频率与传输开销 |
| 流式缓冲 | 网关暂存部分输出 Token 后再批量推送的机制,用于平衡实时性与传输效率 |
2.2 升级总体架构
本次流式输出能力升级构建于网关数据面之上,形成三层处理架构:
- 接入适配层:兼容各厂商原生流式协议,自动识别并解析不同格式的 SSE 事件流
- 策略处理层:根据配置规则执行格式转换、分块调整、缓冲控制、异常重连等处理
- 统一输出层:以标准化 SSE 格式向下游输出,确保前端仅需一套解析逻辑
三、核心自定义配置能力
3.1 输出格式统一配置
星桥 API 中转站支持将不同厂商的流式输出转换为统一格式,企业可通过控制台全局配置输出规范:
- 事件字段映射:自定义事件类型字段名、数据字段名、结束标记符
- 内容结构标准化:支持纯文本增量、完整内容全量、结构化 JSON 三种输出模式
- 元数据注入:可在流式事件中注入模型名称、请求 ID、Token 用量、耗时统计等附加信息
- 结束事件规范:统一结束标记格式,避免不同厂商
[DONE]标记差异导致的解析异常
3.2 分块粒度与缓冲策略
针对不同终端与网络环境,提供四级分块粒度配置:
表格
| 配置档位 | 典型分块大小 | 适用场景 | 首屏速度 | 传输开销 |
|---|---|---|---|---|
| 极细粒度 | 1-2 Token / 块 | 桌面端高速网络、实时对话场景 | 最快 | 最高 |
| 标准粒度 | 5-8 Token / 块 | 通用 Web 应用、默认推荐 | 较快 | 适中 |
| 平衡粒度 | 15-20 Token / 块 | 移动端、弱网环境 | 中等 | 较低 |
| 粗粒度 | 50+ Token / 块 | 批量处理、后端消费场景 | 较慢 | 最低 |
同时支持自适应缓冲机制:网关根据当前网络延迟与输出速度动态调整分块大小,网络通畅时减小分块提升实时性,网络拥塞时增大分块降低重传概率。
3.3 异常处理与续传能力
- 自动重连:连接异常中断时,网关自动向上游发起续传请求,从中断位置继续输出,前端无感知
- 去重校验:基于 Token 偏移量进行内容去重,避免重连导致的重复输出
- 超时保护:可配置单块最大等待时间,超时自动推送心跳事件维持连接
- 降级策略:上游不支持流式时,网关可模拟流式输出,将完整结果逐块推送,保持前端交互一致性
3.4 事件类型扩展
除标准内容事件外,支持配置多种辅助事件类型:
- 开始事件:推理启动时推送,携带模型信息与预估耗时
- 进度事件:按输出进度百分比推送状态更新
- 用量事件:推理结束后推送最终 Token 消耗量与费用明细
- 错误事件:异常发生时推送结构化错误码与提示信息
四、性能与体验实测数据
以下测试数据基于星宇智算实验室基准环境(单网关节点:16 核 CPU、32GB 内存,接入 5 家主流大模型 API):
表格
| 指标项 | 优化前(透传模式) | 优化后(自定义配置) | 变化幅度 |
|---|---|---|---|
| 前端适配工作量(按模型数) | 每个模型独立适配 | 一次适配全模型通用 | -65% |
| 弱网环境首屏展示时间 | 2.1 秒 | 1.2 秒 | -42.9% |
| 流式连接中断率(弱网) | 12.3% | 3.1% | -74.8% |
| 网关流式处理额外延迟 | ~15ms | ~3ms | -80% |
| 单节点并发流式连接数 | 8,000 | 15,000 | +87.5% |
参考行业基准,主流 API 网关开启 SSE 代理后额外延迟通常在 10-20 毫秒区间,星桥 API 中转站通过零拷贝流式处理架构,将网关层额外延迟控制在 3 毫秒以内,对整体首 Token 时延影响可忽略。
五、典型应用场景
智能客服与对话系统
统一流式格式确保多模型切换时前端交互体验一致,标准粒度配置平衡实时性与流畅度,自动重连机制提升网络不稳定场景下的服务连续性。
移动端 AI 应用
粗粒度 + 自适应缓冲配置减少 HTTP 请求分片数,降低移动网络环境下的传输开销与电量消耗,提升弱网地区用户体验。
企业知识库与文档助手
支持配置按段落分块输出,便于前端进行格式渲染与引用标注,结束事件携带完整元数据,方便后续归档与审计。
开发工具与代码助手
极细粒度配置实现逐字输出效果,匹配开发者阅读代码的交互习惯,提升编码辅助场景的沉浸感。
六、接入方式说明
现有星桥 API 中转站用户无需更换接口地址,可通过以下方式启用流式自定义配置:
- 登录星宇智算控制台,进入星桥 API 中转站管理页面
- 在 “流式输出” 模块选择预设模板或自定义各项参数
- 支持全局配置与单应用独立配置,满足不同业务差异化需求
- 配置变更实时生效,无需重启服务或修改代码
新用户可通过星宇智算官网申请免费试用,获得 100 万 Token 调用额度与完整流式配置功能权限。
七、常见问题 FAQ
Q1:开启流式自定义配置后,是否会增加首 Token 时延?
不会产生显著影响。星桥 API 中转站采用零拷贝流式处理架构,网关层仅做格式转换与分块调整,额外处理延迟约 3 毫秒,相对于大模型本身数百毫秒至秒级的首 Token 时延可忽略不计。实测数据显示,启用标准配置后,端到端首 Token 时延差异在 1% 以内,用户无感知。
Q2:如果上游模型本身不支持流式输出,中转站能否模拟流式效果?
可以。星桥 API 中转站提供流式模拟能力,对于仅支持非流式输出的模型,可在获取完整结果后按配置的分块粒度逐块推送,前端无需区分上游是否原生支持流式。该模式下首屏展示时间取决于模型整体推理速度,但交互形态与原生流式保持一致,便于前端统一交互设计。
Q3:流式输出的 Token 计费与非流式是否一致?中断重连是否重复计费?
计费规则一致,均以实际消耗的输入输出 Token 总量为准,与传输方式无关。中断重连场景下,网关通过偏移量标记实现精准续传,已推送过的内容不会重复请求上游,因此不会产生重复计费。重连过程中网关侧的处理与数据传输不额外收取费用。