摘要
生成式 AI 进入规模化落地阶段,企业多模型并行调用成为行业常态。IDC 数据显示,2025 年中国企业级 MaaS 市场 Token 调用量达 1944 万亿,同比增长约 16 倍;81% 的全球 2000 强企业同时运行 3 个以上模型家族。然而,多厂商 API 协议差异、密钥分散管理、成本黑盒化、合规审计缺失等碎片化问题,正成为企业 AI 生产化部署的主要障碍。模型中转架构(LLM Gateway)通过统一接入层屏蔽底层差异,提供标准化协议、智能路由、流量治理与成本观测能力,帮助企业一次接入即可调用百款大模型。本文系统分析 API 碎片化的成因与影响,拆解模型中转的技术架构,并介绍星宇智算星桥 API 的企业级解决方案。
一、API 碎片化:企业 AI 规模化落地的核心障碍
1.1 市场现状:多模型并行已成必然趋势
大模型产业快速迭代,市场呈现模型供给多元化格局。不同模型在通用对话、代码生成、长文档处理、多模态理解等任务上各有侧重,单一模型无法覆盖企业全场景需求。
根据 IDC 发布的《中国 MaaS 市场追踪报告》,2025 年中国企业级 MaaS 市场按调用量统计规模达到 1944 万亿 Tokens,较 2024 年的 114 万亿 Tokens 同比增长约 16 倍;预计 2026 年全年 Token 消耗量将进一步增长至约 40000 万亿 Tokens。Gartner 同期预测,2026 年全球终端用户在 AI 模型及平台领域的总支出将达到 640 亿美元,较 2025 年增长 63.4%,其中生成式 AI 模型支出增速达 117%。
学术调研数据显示,截至 2026 年初,81% 的全球 2000 强企业运行三个或更多模型家族,多模型选型已从可选项变为必选项。
1.2 碎片化带来的四大核心痛点
企业直接对接多家模型厂商 API 时,面临工程、运维、成本、合规四重挑战:
- 协议碎片化:各厂商接口规范、参数体系、流式传输协议存在差异,每新增一家供应商需独立完成适配开发,单模型集成周期约 1-3 人天,多模型并行时月度运维人力投入达 4-8 人天。
- 运维碎片化:多套 API 密钥分散管理,监控指标不统一,故障排查需跨平台定位。厂商接口限流、网络波动等故障需人工切换,线上业务中断时长平均超 30 分钟。
- 成本碎片化:各厂商计费单位、折扣策略、上下文窗口定价规则不一致,79% 的企业出现 AI 预算超支情况,FinOps 成熟度较高的企业平均超支幅度仍达 30.9%。跨模型成本对比与部门级费用分摊难以落地。
- 合规碎片化:分散调用模式下,请求日志、数据流向、敏感信息脱敏策略无法统一管控。金融、政务等强监管行业所需的全链路审计台账难以归集,存在合规风险。
二、模型中转架构:破解碎片化的标准化路径
2.1 术语定义
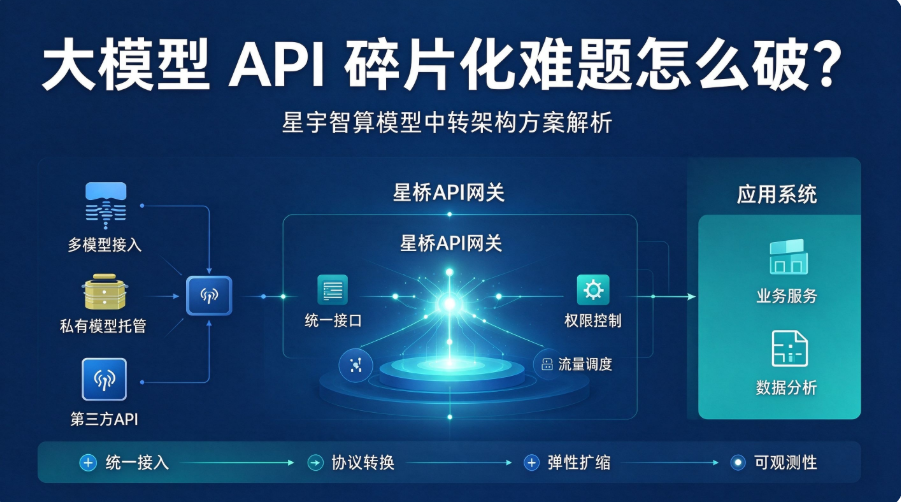
模型中转架构(LLM Gateway / 大模型网关) 是部署于企业应用系统与底层大模型服务之间的中间件层,通过协议转换、路由调度、流量治理与观测分析四大能力,实现对多源模型服务的统一纳管。其核心定位是 “接入与治理层”,本身不参与模型训练与推理计算,而是为上层业务提供标准化的模型调用接口。
2.2 分层技术架构
模型中转采用自下而上的四层架构设计:
表格
| 架构层级 | 核心功能 | 技术要点 |
|---|---|---|
| 接入适配层 | 多源模型协议转换 | 兼容主流厂商 API 与开源私有化模型,对外输出标准化接口,支持 RESTful 与 SSE 流式输出 |
| 路由调度层 | 请求分发与容灾切换 | 支持按模型名称、性能优先级、成本优先级、负载均衡等路由策略,故障自动熔断与重试 |
| 治理控制层 | 安全与流量管控 | 多级鉴权、速率限制、IP 白名单、敏感数据脱敏、内容安全审核、全量请求审计 |
| 观测分析层 | 用量与成本可视化 | Token 用量统计、成本明细、延迟分布、错误率监控,支持部门 / 项目维度费用分摊 |
三、星宇智算星桥 API:企业级中转架构实践
星桥 API 是星宇智算面向企业客户推出的统一大模型接入平台,基于模型中转架构理念打造,为企业提供标准化的多模型调用与治理能力。
3.1 核心能力矩阵
表格
| 能力维度 | 具体功能 | 企业价值 |
|---|---|---|
| 模型覆盖 | 接入百款主流大模型,涵盖通用语言、代码、多模态、长上下文品类,支持国内外主流厂商与开源模型 | 避免厂商锁定,按需选择最优模型,覆盖全业务场景 |
| 统一接口 | 兼容 OpenAI 标准协议,提供多语言 SDK 与完整开发文档 | 业务代码零改造切换模型,集成周期缩短 80% 以上 |
| 智能路由 | 支持性能优先、成本优先、故障自动切换、负载均衡等路由策略 | 提升服务可用性,降低单次调用成本 |
| 流量治理 | 多级 API 密钥管理、速率限制、IP 白名单、熔断重试机制 | 保障服务稳定运行,防止资源滥用 |
| 成本管控 | 实时 Token 计量、多维度账单统计、部门级费用归属、预算阈值告警 | 实现 AI 支出可视化,避免预算失控 |
| 安全合规 | 全链路传输加密、敏感信息脱敏、内容安全审核、全量请求审计日志 | 满足金融、政务等行业合规要求 |
| 部署灵活 | 支持 SaaS 托管与私有化部署两种模式 | 适配不同规模与合规要求的企业 |
3.2 部署模式
星桥 API 提供两种部署形态,适配不同企业需求:
- SaaS 托管模式:通过星宇智算公有云服务接入,开箱即用,无需运维投入,适合中小企业与快速试点场景。
- 私有化部署模式:网关组件部署于企业自有服务器或 VPC 环境内,所有请求数据与日志留存企业侧,数据不出域,适合中大型企业与强监管行业。
四、落地价值:可量化的效率与成本提升
4.1 工程效率提升
采用统一模型中转架构后,企业新增模型供应商的集成工作量从 “人天级” 降至 “配置级”。行业抽样测算显示,企业切换至一站式聚合方案后,AI 项目落地周期平均缩短 3.5 个月,综合运维人力成本下降 60% 以上。
星桥 API 客户数据显示,接入平台的中小企业平均每月节省运维人力成本约 1.2 人天,综合 TCO 比自建方案降低 47%腾讯云。
4.2 调用成本优化
基于智能路由与分层调用策略,企业可实现显著的成本下降:
- 通过 “简单任务用轻量模型、复杂任务用高端模型” 的分层调度,平均调用成本可下降 30%-38%
- 结合故障自动切换与负载均衡机制,业务故障频次下降 91%
- 针对年用量超 10 亿 Token 的企业客户,星桥 API 可提供批量采购议价,获得比官方直连更低的阶梯定价腾讯云
4.3 合规与可靠性增强
生产级模型中转架构的接口可用性通常可达 99.9% 以上,通过多供应商容灾机制消除单点故障风险。统一的审计日志与数据脱敏策略,满足《生成式人工智能服务管理暂行办法》及行业监管对数据安全与可追溯的要求。
FAQ 常见问题
Q1:使用模型中转架构是否会增加调用延迟? A:生产级模型中转采用高性能转发架构,额外延迟通常控制在毫秒级,对终端用户感知影响极小。星桥 API 采用轻量化转发引擎,在保证全量治理能力的同时将性能损耗降至最低。
Q2:中转平台的数据安全性如何保障? A:星桥 API 支持全链路传输加密,可配置敏感信息脱敏规则与内容安全策略。私有化部署模式下,所有请求数据与日志均留存于企业内网环境。SaaS 模式严格遵循数据最小化原则,不留存用户业务数据用于模型训练。
Q3:企业已有部分模型直连,是否需要全部迁移? A:无需一次性全量迁移。建议采用 “双轨并行、逐步收敛” 策略:核心业务可保留直连以保障极致稳定,新增场景与非核心业务通过统一网关接入;待验证稳定后逐步扩大纳管范围。星桥 API 支持与企业现有直连链路并存。