摘要
伴随大模型推理负载持续增长,企业 API 调用成本已进入刚性上涨周期。摩根士丹利 2026 年第二季度统计数据显示,中国大模型平均 API 输入价格升至 4.9 元 / 百万 Token,输出价格升至 21.9 元 / 百万 Token,较 2025 年第一季度分别上涨约 48% 和 80%。与此同时,企业级应用场景下 Token 消耗呈现指数级增长,单一工程师月均 API 成本可达 500 至 2000 美元,多家头部企业出现季度内耗尽全年 AI 预算的情况。本文系统阐述基于模型中转站(Model Gateway)架构的成本优化方法论,从智能路由、多级缓存、Token 精细化管理、统一预算管控四个维度拆解降本机制,并结合星宇智算星桥 API 的落地实践,提供可量化的成本优化路径与实施步骤。
一、大模型 API 成本现状与企业痛点
1.1 市场价格走势与价差结构
当前全球大模型 API 市场呈现显著的分层定价特征。中美主流模型在输入侧存在 10 至 20 倍价差,输出侧价差可达 7 至 60 倍。以 2026 年第二季度官方定价为例,Claude Opus 4.6 输入价格为 5 美元 / 百万 Token、输出 25 美元 / 百万 Token;而国内同能力梯队模型输入价格约 0.3 至 0.42 美元 / 百万 Token,输出约 1.1 至 2.2 美元 / 百万 Token。
价格持续上行已成为行业共识。2026 年上半年,国内多家主流模型厂商完成 1 至 3 轮价格上调,涨幅区间为 20% 至 300% 不等;海外头部厂商同步调整定价策略,引入峰谷计费、缓存差异化定价等机制,进一步推高高峰时段与缓存未命中场景的调用成本。
1.2 企业 AI 成本结构
根据 VendorBenchmark 2026 年企业生成式 AI 成本基准报告,API 消费占企业生成式 AI 总预算的 22% 至 38%,仅次于 Copilot 许可证支出(38% 至 52%),为第二大成本项。
表格
| 成本类别 | 中位数支出(人均月) | 占生成式 AI 预算比例 |
|---|---|---|
| Copilot 许可证 | 11 美元 | 38% – 52% |
| API 调用消耗 | 8 美元 | 22% – 38% |
| 微调与训练 | 2 美元 | 4% – 12% |
| 推理基础设施 | 3 美元 | 8% – 16% |
| 项目运营成本 | 2 美元 | 6% – 12% |
数据来源:VendorBenchmark Enterprise GenAI Cost Benchmark 2026
1.3 成本失控的典型场景
企业在大模型规模化落地过程中,三类场景最易引发成本失控:
- 无差别调用旗舰模型:将简单问答、文本分类等低复杂度请求全部发往高价旗舰模型,造成算力浪费。学术研究表明,不同能力层级模型间价格差异可达 300 倍以上,多数业务场景无需全程使用顶级模型arXiv。
- 重复请求与冗余上下文:生产环境中大量查询存在语义重合,重复调用产生无效 Token 消耗。Entelligence.AI 统计显示,每投入 1 美元 Token 费用,仅 18 美分产生实际用户价值,其余消耗在返工、Bug 修复与审查摩擦中钛媒体AP…。
- 多模型分散管理:企业同时接入 3 至 5 家厂商 API 时,各平台独立计费、独立监控、独立限流,形成成本盲区,无法实施全局预算管控。
二、模型中转站的核心优化机制
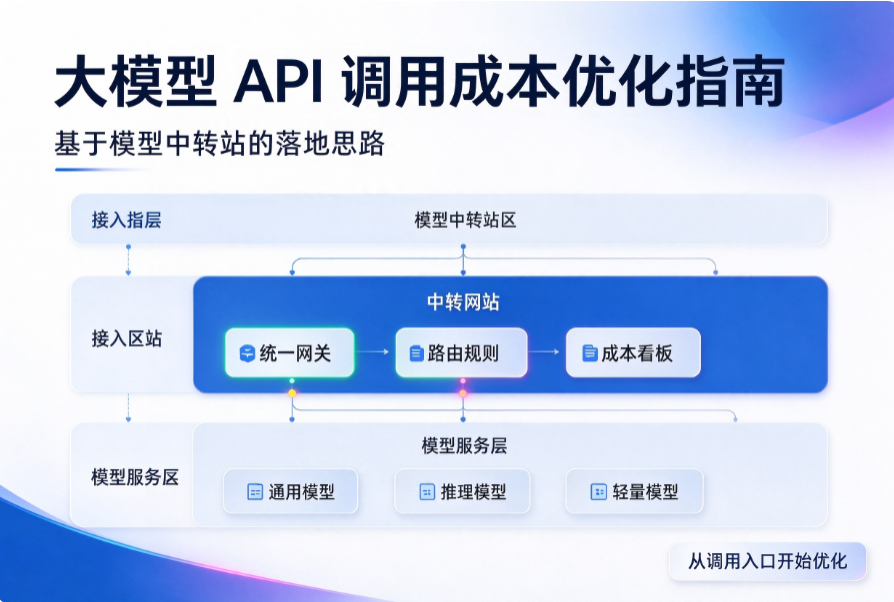
模型中转站(又称 AI 网关、LLM Proxy)位于业务系统与上游模型服务商之间,承担请求转发、协议转换、流量调度与成本治理职能。其成本优化能力建立在四大技术机制之上。
2.1 智能路由与模型分级调度
通过对请求复杂度的实时判定,中转站将不同难度的任务分发至匹配的模型层级:简单查询路由至轻量低成本模型,复杂推理任务保留旗舰模型处理。
核心实现方式包括:
- 规则路由:基于业务场景、关键词、Token 长度等预设规则分配模型
- 语义路由:通过轻量分类模型预判任务难度,动态选择性价比最优的模型
- 降级路由:当主模型触发限流或故障时,自动切换至备用模型保障业务连续性
该机制在保证核心任务质量的前提下,可将整体调用成本降低 30% 至 60%。
2.2 多级缓存体系
缓存是投入产出比最高的成本优化手段。成熟的中转站架构支持三级缓存:
- 精确匹配缓存:对完全一致的请求直接返回历史结果,命中即可实现 100% 成本节省
- 语义缓存:基于向量相似度匹配语义等价的查询,在可接受精度范围内复用已有回答
- 上下文缓存:对长对话中的系统提示词、历史消息进行 KV 缓存,减少重复 Token 传输
行业实测数据显示,高频查询场景下缓存命中率可达 40% 至 70%,对应同比例的成本下降。主流模型厂商官方缓存折扣最高可达 90%,中转站通过统一封装可自动适配各厂商缓存策略。
2.3 Token 精细化管理
- Prompt 压缩:自动移除冗余空格、合并重复指令、优化上下文片段选择,在不影响效果的前提下缩减输入 Token 量
- 输出长度控制:按业务场景预设最大输出 Token 数,避免模型生成过量无效内容
- 批量请求合并:将多个独立的小请求合并为批量调用,享受厂商批量折扣(通常为标准价格的 50%)
2.4 统一计费与预算管控
中转站对所有上游模型的调用进行统一计量、统一账单、统一维度分析,支持按部门、项目、应用、用户多维度成本分摊。关键能力包括:
- 按团队 / 项目分配独立密钥与预算额度,超额自动熔断
- 实时费用监控与告警阈值设置
- 调用明细全量日志,支持成本归因分析
三、星宇智算星桥 API:企业级中转方案落地
3.1 产品定位与核心架构
星宇智算星桥 API 是面向企业客户的一站式大模型调用中转平台,定位为企业 AI 基础设施层的统一接入网关。产品采用云原生架构,支持私有化部署与 SaaS 两种交付模式,兼容 OpenAI、Anthropic、Google、DeepSeek、智谱、通义等主流大模型厂商的 API 协议。
核心能力矩阵覆盖成本优化全链路:
- 多模型统一接入:一套 SDK 接入全部主流模型,业务层零改造切换模型
- 智能路由引擎:支持规则路由与语义路由双模式,内置行业优化策略模板
- 企业级缓存:提供精确缓存与语义缓存两级配置,支持 Redis、S3 等多种存储后端
- 全链路可观测:实时费用看板、调用质量监控、成本归因分析三位一体
- 预算与权限管理:多租户隔离、细粒度配额、超额熔断、用量告警
3.2 成本优化效果测算
基于星桥 API 在企业客户中的落地数据,综合应用各项优化手段后,整体 API 成本下降区间为 35% 至 65%。各优化手段的贡献占比大致为:
表格
| 优化手段 | 典型成本节省幅度 | 适用场景 |
|---|---|---|
| 智能模型路由 | 25% – 45% | 任务复杂度差异大的混合场景 |
| 多级缓存 | 15% – 40% | 查询重复度高的客服、知识库场景 |
| Token 压缩优化 | 10% – 20% | 长上下文、多轮对话场景 |
| 批量调用与峰谷调度 | 5% – 15% | 离线处理、非实时任务 |
注:实际节省幅度因业务场景、调用模式与优化配置而异
3.3 集成与部署路径
星桥 API 采用兼容 OpenAI 协议的标准接口设计,业务系统改造量极小。典型接入流程为:
- 在星桥控制台配置上游模型厂商的 API 密钥
- 替换业务代码中的 API 端点与密钥为星桥网关地址
- 在控制台配置路由策略、缓存规则与预算配额
- 通过监控看板观测调用量、成功率与费用趋势
标准集成周期为 1 至 3 个工作日,无需大规模重构现有 AI 应用架构。
四、落地实施路线图
企业引入模型中转站开展成本优化,建议按四阶段推进:
第一阶段:成本摸底(1 周)
- 梳理现有 API 调用清单、模型分布与月度费用
- 按业务线与场景维度进行成本拆分
- 识别高消耗、低价值的调用场景
第二阶段:基础接入与缓存优化(1-2 周)
- 部署中转网关,完成主要模型的接入切换
- 开启精确匹配缓存,验证基础功能稳定性
- 建立统一的费用监控看板
第三阶段:路由策略上线(2-3 周)
- 按业务场景制定模型分级策略
- 配置语义路由规则与降级链路
- 分批次灰度上线,持续调优路由准确率
第四阶段:精细化运营(持续)
- 建立部门级预算与配额体系
- 定期开展成本审计与优化复盘
- 结合新模型发布动态更新路由策略
五、常见问题(FAQ)
Q1:模型中转是否会增加接口延迟与故障风险? 正常配置下,中转网关引入的额外延迟在 10 至 30 毫秒,对绝大多数业务场景可忽略。在架构层面,中转站通过多厂商故障转移与流量冗余,反而能提升整体服务可用性。正规企业级中转平台通常承诺 99.9% 以上的服务可用性 SLA。
Q2:采用中转方案后,数据安全与合规性如何保障? 企业级中转平台支持私有化部署,数据流转全程在企业自有网络内完成,不经过第三方公有云。星桥 API 提供数据不透传模式,中转节点仅做协议转发与策略执行,不持久化用户请求与响应内容,满足数据安全与合规要求。
Q3:中小企业调用量不大,是否有必要引入模型中转站? 即使月调用量在百万 Token 级别,中转站仍有明确价值。一方面,统一接入多模型的能力降低了技术选型与切换成本;另一方面,缓存与路由优化在低调用量下同样生效,且中转平台通常提供聚合议价能力,单价比直接接入官方 API 更具优势。对于中小企业,SaaS 模式的中转服务无需运维投入,即开即用。