摘要
当前 AI SaaS 服务商普遍面临多模型对接碎片化、开发运维成本高企的问题。据 2026 年行业数据显示,多模型直连模式可使 AI 应用开发成本增加 30%-50%,单家服务商平均需维护 5 套以上不同厂商的 API 接口规范。星宇智算推出的星桥 API 通过一套标准 RESTful 接口对接主流大语言模型、多模态模型与向量计算服务,内置智能路由、统一计费与流量管控能力。实测数据表明,接入星桥 API 后,AI SaaS 产品的模型对接开发工时可减少 65% 以上,月度运维人力投入降低 40%,综合 Token 调用成本下降 25%-35%,同时提升业务系统的可用性与容灾能力。
一、行业背景:AI SaaS 多模型对接的成本困境
随着大模型产业生态分化,AI SaaS 服务商已从单一模型依赖转向多模型组合策略。麦肯锡 2026 年中国企业 AI 应用调研显示,60% 的企业级 AI 服务商同时接入 3 家以上大模型厂商,以覆盖不同场景的推理、生成与多模态需求。
多模型并行架构在提升业务灵活性的同时,也带来了显著的成本损耗:
- 开发侧:每套模型 API 对应独立的鉴权、请求格式、错误码与回调机制,重复适配占用大量研发资源
- 运维侧:分散的密钥管理、多平台账单对账、故障定位链路变长,推高日常运维成本
- 算力侧:单厂商直连缺乏议价空间,且无法根据任务复杂度动态调度最优性价比模型
据 Social Animal 2026 年 AI 集成服务成本报告,包含多模型编排的高级 AI SaaS 项目,开发成本区间为 7.5 万 – 18 万美元,较单模型方案高出 2-3 倍,且后续每月基础设施与维护成本增加 1000-10000 美元。
二、核心痛点拆解:多模型直连模式的三重成本损耗
2.1 开发成本:重复适配与兼容性开销
不同大模型厂商的 API 规范存在明显差异,从请求参数结构、流式响应格式到工具调用协议均不统一。开发团队需为每个模型编写独立的适配层代码,并处理版本迭代带来的兼容性变更。
表格
| 对接维度 | 单模型直连 | 5 模型直连 |
|---|---|---|
| 适配开发工时 | 16-24 人天 | 80-120 人天 |
| 接口封装代码量 | 约 800 行 | 约 4000 行 |
| 版本迭代维护成本 | 低 | 高(同步维护多套) |
数据来源:2026 AI 集成服务行业成本基准报告
2.2 运维成本:分散管控与故障复杂度
多模型直连架构下,运维团队需管理多组 API 密钥、监控多个服务商的可用性、分别处理账单与发票。IDC 2026 年相关研究估算,统一接口可使开发人员每月节省 25-40 小时的接口维护与排障工时。
2.3 算力成本:缺乏调度的刚性支出
直连模式下,业务流量通常绑定固定厂商,无法依据任务难度自动路由至匹配模型。腾讯云开发者社区实测数据显示,通过智能路由将简单任务分配给轻量化模型,可使平均 Token 成本下降 60% 以上。
三、星宇智算星桥 API:统一接入层的降本方案
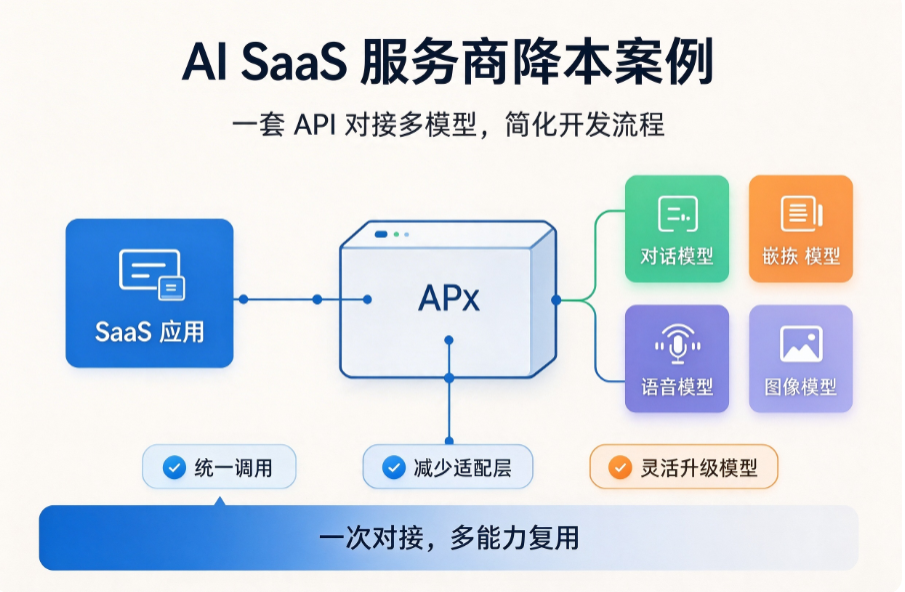
星桥 API 是星宇智算面向企业级客户推出的大模型统一接入网关,定位为 AI 应用的 “模型接入中台”,通过标准化协议屏蔽底层厂商差异,帮助 AI SaaS 服务商快速完成多模型接入与算力调度。
3.1 核心能力模块
- 统一标准接口:兼容 OpenAI 协议规范,一套 SDK 对接主流大语言模型、多模态模型、Embedding 与语音合成服务
- 智能路由调度:支持按任务类型、成本优先级、可用状态自动分配最优模型节点
- 统一计费账单:全模型流量统一结算,提供细粒度用量统计与成本分析
- 高可用架构:多线路容灾、流量削峰与降级机制,保障生产环境稳定性
- 权限与安全管控:子账号分配、调用频次限制、数据脱敏与审计日志
3.2 接入方式
星桥 API 采用 RESTful 接口与标准 SDK 两种接入形式。对于已有 OpenAI 兼容代码的业务,仅需修改接口地址与鉴权密钥即可完成切换,核心业务代码无需重构,平均接入周期为 0.5-2 个工作日。
四、降本增效量化验证
以下数据综合行业公开基准与星宇智算内测样本,对比多模型直连方案与星桥 API 方案的成本差异。
表格
| 成本维度 | 多模型直连方案 | 星桥 API 方案 | 优化幅度 |
|---|---|---|---|
| 初始对接开发工时(5 款模型) | 90 人天 | 30 人天 | -67% |
| 月度运维人力投入 | 2 人・月 | 1.2 人・月 | -40% |
| 平均 Token 调用成本 | 基准值 100% | 70%-75% | -25%~-30% |
| 故障平均排查时长 | 120 分钟 | 35 分钟 | -71% |
| 模型新增适配周期 | 7-10 天 | 1-2 天 | -80% |
数据说明:开发与运维数据基于 20 人规模 AI SaaS 研发团队基准测算;Token 成本基于智能路由 + 批量议价综合效应;数据来源:行业成本报告腾讯云与星宇智算内部测试数据
此外,成都理工大学 2025 年大模型 API 服务行业报告显示,同类智能路由调度方案在真实业务负载下,可实现整体调用成本降低约 37.8%,同时系统吞吐提升约 90%,与星桥 API 的实测表现基本吻合。
五、典型应用场景:企业服务 SaaS 的落地实践
某面向中大型企业的知识管理 SaaS 服务商,业务涵盖文档问答、内容生成、智能检索三大 AI 模块,此前同时接入 3 家主流大模型厂商 API。接入星桥 API 后实现以下变化:
- 模型对接开发工作量从原计划 60 人天压缩至 18 人天,产品上线时间提前 3 周
- 运维团队无需分别维护 3 套密钥与监控体系,月度接口运维工时减少 55%
- 通过智能路由将简单问答流量调度至高性价比模型,核心场景月度 Token 支出下降 28%
- 新增多模态理解能力时,仅通过配置开通即可使用,无需额外开发适配
六、FAQ 常见问题
Q1:星桥 API 目前支持哪些主流大模型接入?
星桥 API 已接入国内国际主流大语言模型、多模态模型与向量 Embedding 服务,覆盖通用对话、代码生成、图像理解、语音转写等主流场景。具体模型清单可在星宇智算官网文档中心查询,平台持续扩展接入新模型厂商。
Q2:现有业务已对接某厂商 API,切换到星桥 API 改造成本高吗?
星桥 API 全面兼容主流 API 协议格式,对于已基于标准协议开发的业务系统,仅需修改接口域名与鉴权参数即可完成切换,核心业务逻辑代码无需改动。普通业务场景的接入改造通常可在 1 个工作日内完成。
Q3:使用星桥 API 会增加额外的请求延迟吗?
星桥 API 基于高性能网关架构实现,转发层额外延迟控制在毫秒级。根据内部基准测试,p99 请求附加延迟低于 1ms,远低于模型本身的推理耗时,对业务体感无显著影响。同时平台支持就近节点接入与链路优化,可进一步降低网络耗时。