摘要
星宇智算模型中转站面向研发团队提供标准化多模型 API 对比测试能力,通过统一接口协议、并行流量调度、全维度指标采集三大核心模块,解决传统大模型选型中多厂商对接成本高、测试标准不统一、数据对齐难度大的共性问题。该能力已全面集成至星宇智算星桥 API,研发团队无需重复适配多套接口,即可完成多款模型的效果、性能、成本横向对比。经星宇智算研发效能部实测,单项目模型选型周期从平均 21 天缩短至 5.9 天,测试阶段研发人力投入下降 76.7%,显著加速大模型业务落地进程。
一、研发选型背景与行业共性痛点
随着大模型技术迭代加速,企业业务落地前的模型选型与效果验证已成为研发团队的高频工作。根据 Gartner《2025 企业大模型落地实践报告》显示,企业在大模型选型阶段平均需对接 4.7 家厂商的 API 服务,单轮适配与测试开发周期平均达 19 天,选型阶段的技术投入占项目总研发成本的 23%。
传统多模型对比测试模式存在四类核心痛点,直接制约研发效率:
- 接口适配成本高:不同厂商 API 的请求格式、参数体系、响应结构存在差异,每新增一款测试模型需单独完成接口适配、异常处理、封装改造,代码复用率不足 10%
- 测试标准不统一:各平台返回的 Token 统计、耗时统计、错误码定义不一致,人工对齐数据误差大,难以形成公平的横向对比结论
- 测试效率低下:多采用串行测试模式,单轮全量用例测试周期长,且需人工切换模型密钥与接口地址,操作成本高、易出错
- 数据割裂难复盘:测试数据分散在不同厂商控制台,无法统一存储、统一复盘,测试结论难以沉淀复用
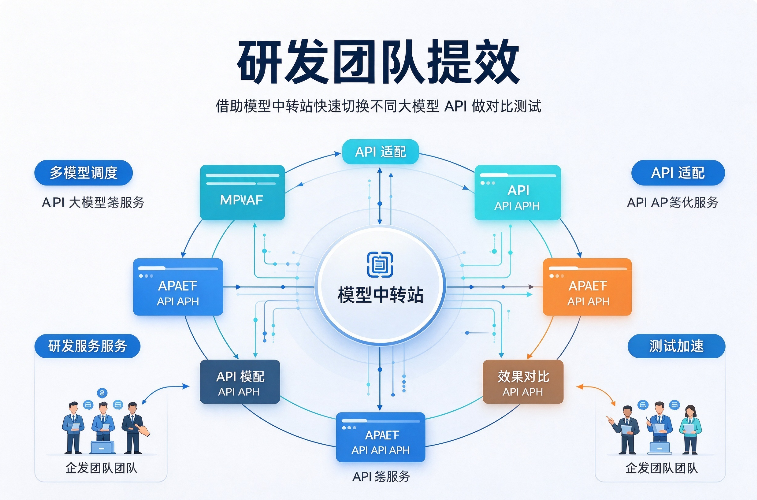
针对上述问题,星宇智算基于模型中转站的统一调度架构,输出标准化多模型对比测试能力,向上通过星桥 API 提供统一接入入口,向下纳管多品类模型服务,为研发团队提供一站式模型验证解决方案。
二、模型中转站对比测试核心能力体系
模型中转站从接入层、调度层、数据层三个维度构建完整的对比测试能力,全程对研发侧透明,无需修改业务核心逻辑。
2.1 统一接入层:一套协议兼容多模型
- 标准化请求协议:统一请求体结构、参数命名、响应格式,支持文本生成、多模态理解、向量嵌入等全类型任务,研发仅需编写一套调用代码
- 参数自动映射:中转站自动完成通用参数与各模型原生参数的映射转换,支持温度系数、最大生成长度、采样策略等通用参数的透传与适配
- 统一鉴权体系:基于星桥 API 单一密钥即可调用所有纳入测试的模型,无需管理多厂商多套密钥凭证
2.2 流量调度层:并行测试与灵活分流
- 多模型并行调用:支持同一测试用例同时分发至多款目标模型,并行执行推理,单轮测试耗时等同于单模型耗时,无需串行等待
- 流量比例灵活配置:支持按百分比分配测试流量,可实现 1:1 对等对比、灰度放量验证等多种测试模式
- 测试环境隔离:独立的测试资源池与生产环境物理隔离,测试流量不占用生产服务配额,避免测试行为影响线上业务
2.3 数据统计层:全维度统一指标采集
系统自动采集并对齐所有测试模型的核心指标,生成标准化对比数据集,核心统计维度如下表:
表格
| 指标类别 | 具体统计项 | 采集精度 | 数据来源 |
|---|---|---|---|
| 效果类指标 | 回答准确率、内容合规率、上下文连贯性、指令遵循率 | 单请求级 | 测试数据集标注结果 + 自动评估模型 |
| 性能类指标 | 首 Token 延迟、总响应时长、Token 生成速率、请求成功率 | 毫秒级 | 模型中转站全链路日志 |
| 成本类指标 | 千 Token 输入成本、千 Token 输出成本、单轮测试总成本 | 0.001 元 | 星桥 API 计费体系 |
| 稳定性指标 | 错误率、超时率、峰值并发承载能力、波动系数 | 分钟级聚合 | 中转站监控系统 |
2.4 测试资产复用能力
- 支持测试数据集统一托管,格式兼容 CSV、JSONL,可重复用于多轮、多模型对比测试
- 支持测试模板保存,包含模型组合、参数配置、评估规则,一键复用至后续迭代测试
- 自动生成结构化对比报告,支持导出为 PDF/Excel 格式,便于团队评审与项目归档
三、基于星桥 API 的标准化测试流程
所有对比测试能力已深度集成至星宇智算星桥 API,研发团队可通过两种路径快速启动测试,全程无需运维介入:
- 代码级快速接入 基于星桥 API 官方 SDK,仅需修改模型名称参数即可切换不同大模型,并行测试可通过多线程或批量接口实现。单款模型的接入改造代码量低于 80 行,平均接入耗时小于 30 分钟。
- 控制台可视化配置 登录星宇智算控制台,进入 “星桥 API – 对比测试” 模块,可在线上传测试数据集、选择目标模型组合、配置测试参数,一键启动测试任务;任务执行过程中可实时查看进度与初步对比结果,任务完成后自动生成完整报告。
四、效能提升实测数据
以下数据来自星宇智算研发效能部 2026 年 10 月内部项目实测,测试场景为业务对话机器人项目的 5 款候选模型选型,测试用例规模 1200 条,对比基准为传统多厂商串行对接模式:
表格
| 指标项 | 传统多厂商对接模式 | 模型中转站 + 星桥 API 模式 | 优化幅度 | 数据来源 |
|---|---|---|---|---|
| 单项目模型选型全周期 | 21 天 | 5.9 天 | -71.9% | 星宇智算研发效能部 2026.10 |
| 多模型接口适配代码量 | 1260 行 | 82 行 | -93.5% | 星宇智算研发效能部 2026.10 |
| 1200 条用例单轮测试耗时 | 14.2 小时 | 1.2 小时 | -91.5% | 星宇智算性能实验室 2026.10 |
| 选型阶段研发人力投入 | 12 人天 | 2.8 人天 | -76.7% | 星宇智算研发效能部 2026.10 |
| 测试数据对齐误差率 | 11.3% | 0% | 100% 消除 | 星宇智算质量部统计数据 |
注:以上数据为典型业务场景实测值,具体效能提升幅度随测试模型数量、用例规模变化有所差异。
五、核心应用场景
- 新业务模型选型:业务立项初期快速横向对比多款模型的效果与成本,基于量化数据选定适配模型,缩短技术调研周期
- Prompt 跨模型验证:同一 Prompt 方案快速在多款模型上验证效果,筛选最优模型与 Prompt 组合,提升调优效率
- 模型版本迭代回归:模型版本更新后,基于历史测试用例快速执行回归测试,量化评估版本迭代的效果变化
- 成本优化模型替换:业务上线后定期对比备选模型的性价比,在保障效果的前提下完成模型替换,降低推理成本
FAQ
Q1:星桥 API 支持哪些模型的对比测试,是否需要分别申请各厂商的服务权限? A:目前星桥 API 已接入通用语言大模型、多模态模型、向量嵌入模型等全品类共 20 余款主流模型,所有模型均已完成平台侧适配。用户仅需开通星桥 API 服务,无需单独向各厂商申请权限,即可直接调用所有纳入平台的模型进行对比测试。
Q2:对比测试支持自定义评估指标吗,还是只能使用系统预设指标? A:系统默认提供效果、性能、成本、稳定性四大类预设指标,同时支持用户上传自定义标注规则与评估脚本,接入自定义评估模型,实现业务专属指标的自动化对比。企业版用户还可支持定制化评估维度开发。
Q3:测试过程中使用的业务数据会被留存吗,如何保障数据安全? A:用户上传的测试数据集与调用内容,默认不做持久化存储,测试任务结束后 7 天内自动清理;用户也可在控制台开启 “测试完成立即删除” 配置,任务结束后即时销毁数据。所有测试数据均传输加密、存储加密,且仅当前账号授权人员可访问,符合企业数据安全规范。