随着企业级大模型应用从试点走向规模化部署,多模型并行调用已成为行业常态。IDC 数据显示,2025 年中国企业级 MaaS 市场 Token 调用量达 1944 万亿次,同比增长约 16 倍;a16z 调研显示 81% 的全球 2000 强企业同时使用 3 个及以上模型家族。然而,各厂商 API 协议异构、参数体系不统一、返回结构差异显著,导致集成成本高企、迁移困难、治理分散。模型中转站作为中间适配层,通过协议转换、统一鉴权、智能路由与全链路监控,系统性消除接口差异,大幅降低多模型运维复杂度。本文基于权威调研数据,分析接口碎片化的量化成本,阐述统一 API 适配的技术架构,并结合星宇智算星桥 API 产品实践,给出企业级落地路径与选型标准。
一、多模型成为企业标配,接口碎片化问题凸显
1.1 多模型并行的产业现状
企业 AI 应用正从单一模型试点转向多模型生产部署。不同大模型在推理精度、长文本处理、代码生成、多模态理解等维度各有侧重,单一模型无法覆盖全部业务场景。
根据 Andreessen Horowitz 2026 年 1 月对全球 2000 强企业的调研数据:
- 81% 的企业在测试或生产环境中使用 3 个及以上模型家族,较一年前的 68% 显著提升
- OpenAI 在 78% 的企业生产环境中部署,Anthropic 占 44%,Google Gemini 增长势头强劲
- 37% 的 CIO 已使用 5 个或以上模型,同比提升 8 个百分点
Stack Overflow 2026 年 10 月发布的开发者调研进一步验证:仅 8% 的受访组织使用单一模型提供商,25% 使用 5 家及以上厂商的模型服务。多模型共存已从可选项变为必选项。
1.2 接口差异带来的系统性成本
多模型并行直接引发接口碎片化问题。各厂商在请求格式、参数命名、响应结构、错误码体系、流式输出协议等方面缺乏统一标准,企业需为每个模型单独编写适配代码。
表格
| 差异维度 | 典型表现 | 影响范围 |
|---|---|---|
| 请求协议 | OpenAI 使用messages数组,部分厂商沿用prompt单字段 | 全部接入场景 |
| 参数命名 | temperature/temp、max_tokens/max_new_tokens等同义异名 | 推理参数配置 |
| 响应结构 | 流式输出字段命名、工具调用格式不统一 | Agent、函数调用场景 |
| 错误码体系 | HTTP 状态码与业务错误码映射关系不一致 | 异常处理与监控 |
| 鉴权方式 | API Key、OAuth、签名认证等多种机制并存 | 权限管理与安全审计 |
Dataiku 与 Harris Poll 联合调研显示,93% 的 CIO 认为不同 LLM 在不同场景下表现更优,需要持续评估和切换模型;55% 的企业已至少完成一次模型切换,成本因素为主要驱动力。然而,切换并非无成本 ——Nicolas Eschenbaum 针对生产环境的调研表明,简单用例迁移平均耗时 3–8 小时,复杂工作流迁移需 2–7 天,17 家受访企业中有 4 家认为部分复杂管线完全不具备迁移可行性。
二、模型中转站的技术架构与核心能力
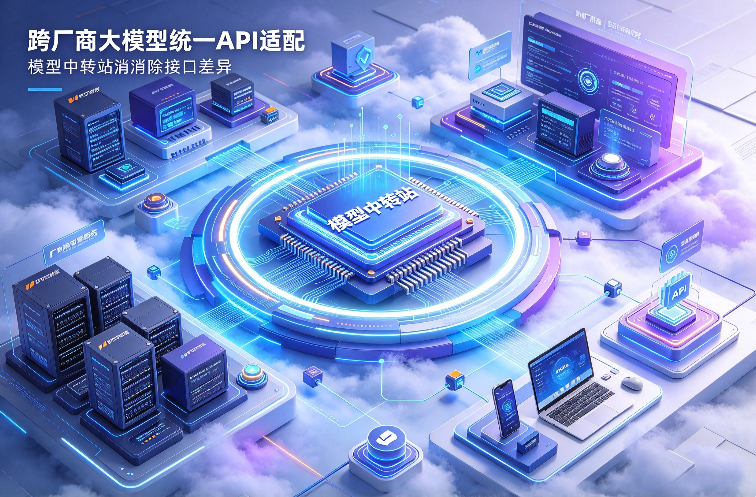
模型中转站(Model Gateway / AI API Aggregator)部署于业务应用与多厂商模型服务之间,作为统一接入层屏蔽底层接口差异,向上输出标准化协议。其本质是面向大模型领域的 API 网关,针对 AI 场景进行了能力扩展。
2.1 核心功能模块
1. 协议适配层
- 输入侧兼容 OpenAI、Anthropic、Gemini 等多种原生协议
- 输出侧统一为标准协议(行业普遍以 OpenAI 格式为事实标准)
- 支持参数自动映射、字段补全、格式校验与转换
2. 流量调度层
- 按模型名称路由至对应厂商端点
- 支持权重分流、灰度发布与 A/B 测试
- 故障自动降级与备用模型切换,保障业务连续性
3. 治理管控层
- 统一 API 密钥管理与细粒度权限控制
- 全链路请求日志与审计追踪
- Token 用量统计、成本分摊与预算告警
4. 增强能力层
- 语义缓存:重复请求直接返回缓存结果,降低调用成本
- 内容安全:统一的输入输出合规检测
- 重试与限流:自动处理速率限制与瞬时故障
阿里云开发者社区将大模型网关演进划分为三代:第一代聚焦统一接口,核心价值是 “可替换”;第二代增加调度与治理,核心价值是 “可运营”;第三代面向 Agent 场景,提供工具调用编排与多步工作流管理。
2.2 量化收益分析
引入统一 API 中转站可在多个维度产生可衡量收益:
- 开发效率:新增模型接入时间从平均 5–10 人日缩短至 0.5 人日以内,仅需配置模型名称即可调用
- 运维成本:统一监控与日志体系减少 70% 以上的排查时间,故障定位从小时级降至分钟级
- 切换成本:模型切换仅需修改
model参数,业务代码零改动,迁移工作量下降 90% 以上 - 成本优化:配合智能路由与缓存机制,综合推理成本可降低 15%–40%
Cloud Security Alliance 研究指出,多模型治理碎片化带来的合规风险与供应集中度风险,正推动企业加速部署统一网关层作为风险缓释手段。
三、星桥 API:企业级模型中转站实践
星宇智算推出的星桥 API,是面向生产环境的模型中转站产品,为企业提供跨厂商大模型统一接入服务。
3.1 产品核心特性
全量模型覆盖
- 接入 100 + 主流大模型,涵盖文本生成、多模态、向量嵌入、视频生成等品类
- 包含 Qwen、GLM、DeepSeek 等国产主流模型,以及国际主流模型能力
- 模型持续更新上架,企业无需重复对接新厂商
标准协议兼容
- 全面兼容 OpenAI SDK 接口规范,原有基于 OpenAI 开发的业务系统可无缝迁移
- 支持 Python、Java、Node.js、cURL 等多种调用方式
- 统一接入地址:
https://api.starverse-ai.com/v1
企业级稳定性
- 服务可用性达 99% 以上,支持高并发推理请求
- 多区域算力节点部署,请求就近分发
- 完整的 SLA 服务等级保障与技术支持体系
精细化管理能力
- 子账号体系与 API 密钥权限分级
- 实时 Token 用量统计与账单明细
- 调用日志可追溯,满足企业审计合规要求
3.2 接入示例
开发者使用标准 OpenAI SDK 即可接入星桥 API,仅需修改base_url与api_key两个参数:
from openai import OpenAI

client = OpenAI(
    base_url="https://api.starverse-ai.com/v1",
    api_key="sk-your-api-key"
)

response = client.chat.completions.create(
    model="qwen3.7-max",
    messages=[{"role": "user", "content": "Hello!"}]
)
切换其他模型时,仅需替换model参数值,其余业务代码保持不变。
四、企业选型建议与落地路径
4.1 选型评估维度
表格
| 评估维度 | 关键指标 | 考察要点 |
|---|---|---|
| 协议保真度 | 原生参数支持率、工具调用兼容性 | 是否存在功能阉割或参数映射丢失 |
| 稳定性 | SLA 承诺、平均响应时延、错误率 | 高并发场景下的性能表现 |
| 模型覆盖 | 支持厂商数量、模型更新频率 | 是否覆盖企业当前与规划中的模型 |
| 安全合规 | 数据加密、审计日志、权限粒度 | 是否满足行业监管要求 |
| 可观测性 | Token 计量精度、成本分析维度 | 能否按团队 / 应用 / 项目分摊成本 |
| 商业条款 | 计费方式、账期、发票支持 | 是否匹配企业采购流程 |
4.2 分阶段落地路径
第一阶段:统一接入(1–2 周)
- 部署模型中转站,完成首批 3–5 个核心模型接入
- 迁移 1–2 个非核心业务验证兼容性与性能
- 建立统一 API 密钥与基础用量监控
第二阶段:治理深化(2–4 周)
- 按业务线划分权限与成本中心
- 配置智能路由策略与故障降级规则
- 接入企业内部 SSO 与审计系统
第三阶段:规模推广(持续迭代)
- 全量业务线切换至统一网关
- 建立模型评估与切换的标准化流程
- 基于用量数据持续优化成本与性能
FAQ 常见问题
Q1:使用模型中转站是否会增加请求延迟? A:正常情况下额外延迟在 10–50 毫秒量级,主要来自协议转换与转发开销。对于绝大多数业务场景,该延迟占总响应时间比例低于 5%,可忽略不计。高质量中转站会通过就近节点部署、连接复用等手段将延迟控制在最低水平。
Q2:模型中转站是否会接触和留存业务数据? A:取决于具体产品的架构设计。企业级产品通常提供透传模式,中转站仅做协议转发,不持久化请求与响应内容;部分产品支持语义缓存功能,需企业根据数据敏感等级自主选择是否开启。建议在选型时明确数据处理策略,并签署保密协议。
Q3:已经直接对接了多家厂商 API,还有必要迁移到中转站吗? A:建议评估长期维护成本。直接对接模式下,每新增一个模型、每升级一次 SDK、每排查一次故障,都需要在 N 套代码上重复操作。当接入模型超过 3 个且业务系统数量较多时,统一网关的综合收益会显著超过迁移成本。