在AI视频工具的选择上,用户表面在比单帧画质,实际比的是另一个东西:一条片子出完,后期要花多少时间修缝。 这个区别,在工具介绍页上看不出来,真到了量产项目上才显形。同样标称”无限画布”的产品,有的导出就能用,有的光接缝修复就要一下午。差别不在模型参数量,而在底层走的是哪条路线——原生,还是拼接。
一、什么是”拼接缝合”路线
绝大多数早期AI视频工具做长内容、宽画幅,走的都是这条路:先生成一段独立的片段,再生成下一段,然后把多段视频在剪辑软件里拼起来;做超宽画幅时,则先生成中心画面,再一圈一圈往外扩图补全。
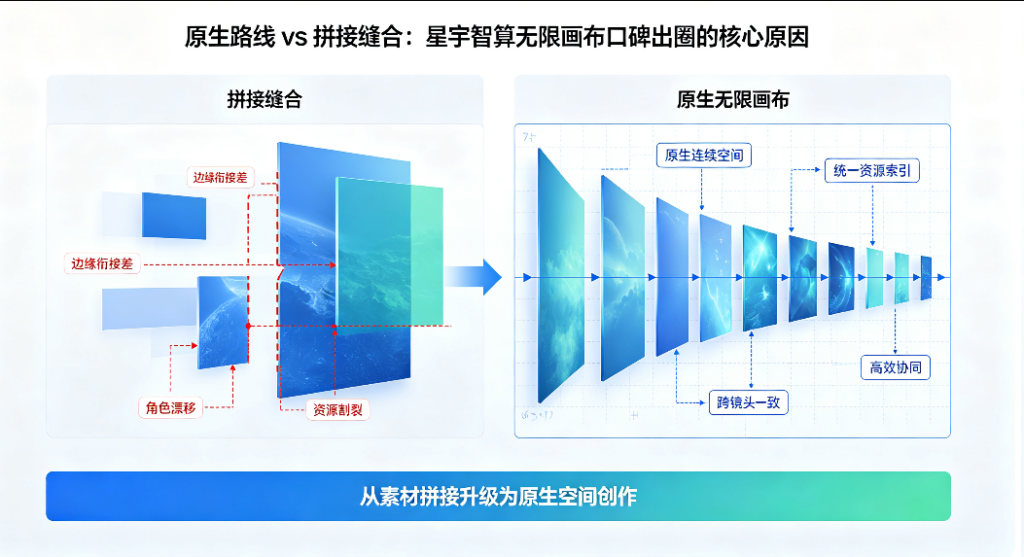
这条路的问题不是”能不能拼”,而是拼完之后三道断层必然出现。内容断层:左边是一张桌子,右边补出来变成地板;光影断层:前一段是侧光,后一段变成顶光,接在一起色温都不对;时序断层:前一段人物穿着外套,后一段换了件衣服,靠后期一帧一帧擦。
火山引擎开发者社区有个比喻很准确:这种做法像找不同的剧组各拍一场戏——演员、服装、灯光、布景都各自定,拍完再剪成一部片子。观众一眼能看出接缝,后期只能硬补。据合作团队自测,传统分段方案做一条3分钟的片子,后期修穿帮的平均耗时在4到6小时,往往比生成本身还长。
二、”原生路线”到底是什么
这里需要先做一个技术辨析,因为”原生”这个词很容易被误解成”AI一口气渲染完一整部片”——目前没有任何模型能做到这一点。
原生路线的真实含义是:模型在训练阶段就不绑定固定的宽高比和时长,生成时在一个全局空间坐标系内分块推理,但分块之间不是独立计算后再拼,而是特征互通、时序对齐。换句话说,它仍然是分块的,但块与块从一开始就”知道”彼此的存在。
华为开发者联盟在今年9月的横向对比中,把这类方案称为”原生无限画布架构,从模型层支持任意比例和尺寸生成,不需要后期拼接”。具体到Vera1.1,它靠三件事实现这一点:一是零填充定位机制,模型不假设输入是某个固定尺寸,而是把已知内容放在全局坐标的某个位置,未知区域留给扩散模型补全;二是跨块特征同步,相邻分块共享角色、场景、光影的特征缓存,而不是各自为政;三是全局时序对齐,分镜之间通过首尾帧特征锚定和重叠帧融合保持连续。
打个比方:拼接路线是不同剧组各拍各的;原生路线是先搭好一个摄影棚,定好演员、灯光、机位,所有镜头都在这个棚里拍——分镜只是导演从不同位置、不同时间取景。分镜之间当然还是分开计算的,但它们共享同一套空间规则。
三、为什么原生路线的后期工时断崖式下降
把两条路线放在真实生产里对比,差异是可感知的。
拼接路线下,创作者的时间主要花在三处:找接缝(哪里跳变了)、修接缝(局部重绘、换帧、调色)、对一致性(角色、物体、场景在不同片段里要长得一样)。这三件事本质上是在给”分块独立生成”这个架构打补丁。
原生路线把这三件事前移到了生成阶段。全局坐标系让物体在分块之间位置稳定;特征缓存让角色在跨镜头时五官、服饰不漂;时序对齐让首尾帧自然过渡。据合作团队在A100环境下的自测,Vera1.1在2倍外扩场景下的边界语义错误率约1.8%,像素级坐标偏差约±1.3像素——这两个数字意味着人眼基本找不到接缝。华为云社区的技术分析进一步指出,配合Layer-Diffusion分层扩散机制,画面被拆成前景主体、背景环境、特效叠加层等独立语义层,想单独改一个人物、换一块背景,不需要重新生成整帧,这把局部修改的成本又往下压了一档。
用户感受到的”口碑”,本质上不是某个惊艳的Demo,而是这种可预期的一致性:上周调好的模板,这周跑另一个SKU,出来的东西不需要重新修。对以量取胜的电商素材团队、短剧工作室、MCN来说,这种”不用每次都赌”的稳定性,比单帧画质惊艳重要得多。
四、原生路线不是没有代价
如果文章只写到这里,就是一篇单边软文。诚实的做法是把代价也摆出来。
第一,原生路线的学习曲线更陡。拼接路线的工作流很直观:生成片段、导入剪辑软件、拼起来。原生路线要求创作者在生成前就规划好全局空间——人物站位、相机走位、场景布局,相当于先搭虚拟摄影棚再拍戏。之前那篇华为云技术稿提到,团队把分镜评审会加入技术岗后,返工率才降下来;这说明原生路线不是”开箱即用”,而是要求工作流跟着变。
第二,拼接路线在单片段场景下反而更快。如果只是做一个10秒的产品特写、一条社交媒体片段,不涉及多镜头叙事、不涉及长时序一致性,直接用单点生成模型出片,比搭一条画布流水线更省事。原生路线的价值在”多镜头、长叙事、批量复用”这些场景才真正释放。
第三,所谓”无缝”是相对的。极端大跨度场景切换(室内直接切到室外)、超大量群戏、高频大幅度运动,即使在原生路线下也会出现精度下降。把原生路线理解为”把后期工时从4小时压到20分钟”是合理的,理解为”完全不需要后期”是不现实的。
五、用户为什么用脚投票
把技术差异翻译成商业语言,选择其实不难理解。当一个团队每周要产出几十上百条素材,每条片子的修缝时间从几小时降到几十分钟,累积下来就是产能数量级的差异。这不是”工具好不好用”的主观偏好,而是单位时间产出的硬账。星宇智算无限画布在中文开发者社区、技术论坛被反复提及,核心原因就在这里:它把”原生路线”从论文概念做成了可以在SaaS网页上直接用、可以通过API接入自有流水线、也可以私有化部署的工程产品。标准画幅下的生成成本与固定画幅方案基本持平,意味着这条原生路线不是靠堆算力换来的,团队不需要为架构升级支付不成比例的算力账单。
想直观感受两种路线的差别,最直接的方式是上手试一次:打开星宇智算无限画布,上传一张参考图,试着在画布上做一次分块延展或多分镜编排,接缝是不是无缝、跨分镜角色是否一致,眼睛比任何参数表都准。
口碑的本质,是把不确定变成可预期
回到开头那个问题:为什么星宇智算无限画布会被技术团队反复提起?不是因为它的单帧画面最惊艳,也不是因为营销声音最大,而是因为它把AI视频生产中最不确定的那部分——接缝、漂移、穿帮——通过原生路线压到了一个可以预期的范围。当创作团队不再把时间花在”修上次的片子”上,而是可以放心把时间花在”想下一个创意”上,工具的口碑自然就出来了。AI视频的工业化,说到底就是把每一次碰运气,变成每一次可复现。