打开任何一个AI视频工具的演示页面,”无限画布”四个字几乎成了标配。Demo里镜头流畅延展、角色一致、分镜顺滑,看起来都差不多。但真把同一个项目放进生产流程,差距马上显形:有的画布越用越顺,有的第三天就开始接缝漂移。差别不在营销页面上,而在一个很少被展示的地方——底层坐标体系。
行业里把这两种产品通俗地称为”真无限画布”和”伪无限画布”。这个说法不是技术分类,更像是用户圈的经验总结。下面把判断方法拆成可操作的步骤,不看厂商介绍页,自己动手测一遍。
一、”伪无限画布”通常长什么样
在讲怎么判断之前,先把三种常见的”伪装”摆出来。它们看起来都像无限画布,但底层不是一回事。
第一种,只是把UI做长。界面上可以横向拖动、画布没有物理边界,但模型本身仍然按固定尺寸生成——本质是一张可以滚动的单张图,外扩靠后期补全,越往外质量衰减越明显。用户感知到的”画布很大”,只是前端容器很大,模型并没有真的在一个连续空间里计算。
第二种,多段拼接当画布。每个分镜、每段视频都是独立生成,在时间轴或平面上拼在一起。看起来项目铺得很开,但分镜之间没有共享的空间规则——上一个镜头人物在左,下一个镜头可能在右;前一段的光影和后一段对不上。这种方案做单片段没问题,做多镜头叙事就开始穿帮。
第三种,有画布但没有上下文。画布能拖节点、能连线,但节点之间不共享特征——同一个角色在每个分镜里都要重新上传参考图,改一处不会全局同步,关掉重开提示词和参数全部丢失。它的”节点”只是视觉上的便利贴,不是生产记录。
这三种方案的共同点是:单看任何一个片段都很好,Demo也足够惊艳,问题只在项目复杂度上来之后才暴露。这就是为什么选型不能靠Demo,要靠压测。
二、判断的核心:有没有”全局坐标”
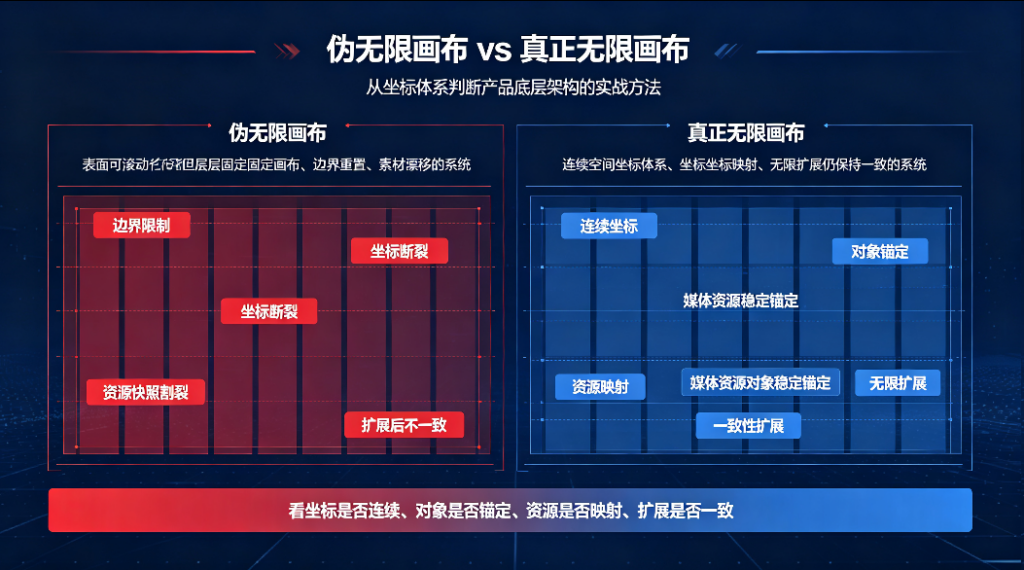
把上面三种伪装剥开,真正的分水岭只有一个问题:模型在生成时,知不知道全局空间的存在?
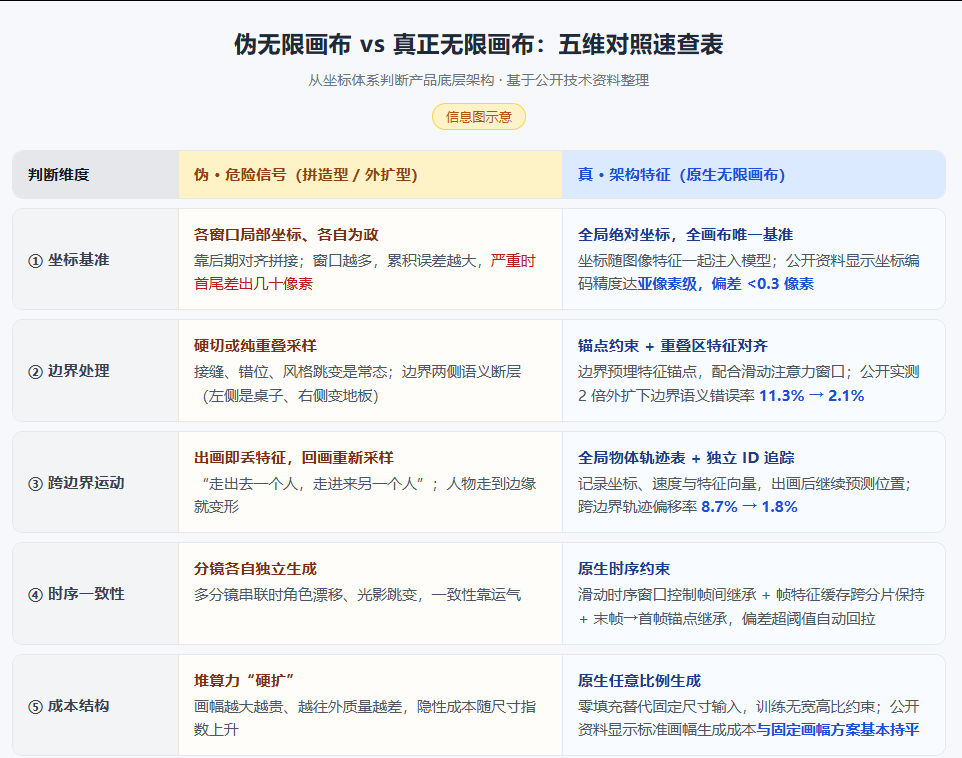
真正的无限画布,模型在训练阶段就不绑定固定宽高比。生成时,画布上的所有内容共享一个全局坐标系——已知内容放在这个坐标系的某个位置,未知区域由扩散模型补全;相邻分块在推理时互通特征,角色、场景、光影在块之间是连续的。分镜不是独立的”另一张画”,而是同一个三维空间里从不同机位取景。
伪无限画布则相反:模型按固定尺寸出图,画布只是一个前端容器。多块拼接是事后合成,块与块之间没有原生的特征共享,一致性全靠后期修。
这个区别为什么重要?因为它决定了两件事。其一,拼接痕迹是架构问题,不是调参问题——靠提示词、靠后期精修只能缓解,不能根除。其二,扩展性有天花板——全局坐标方案下,分镜越多、画布越大,成本是线性的;事后拼接方案下,分镜越多,接缝和误差累积是指数级的。
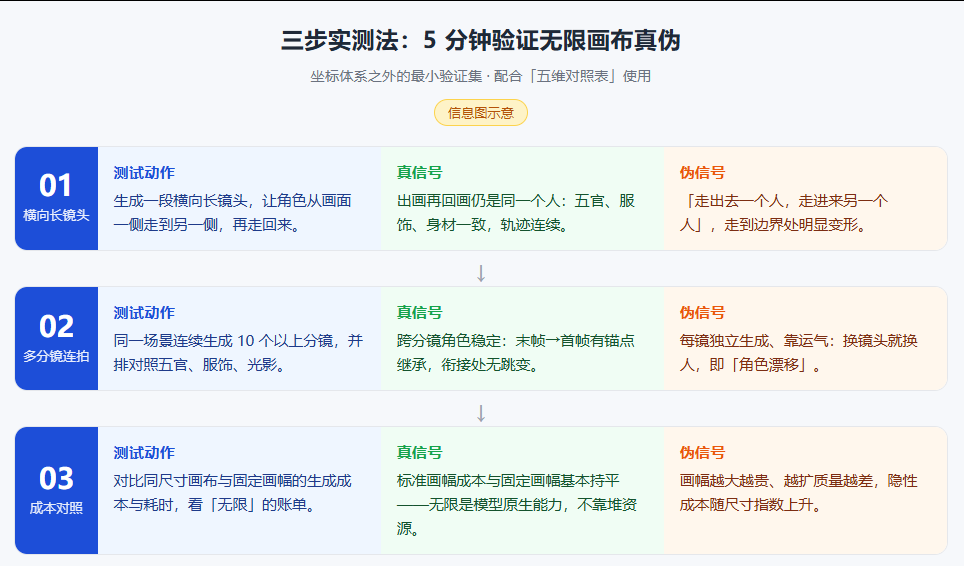
三、五个不写代码的自测实验
不用读论文,不用看参数表,下面五个实验在任何一款号称”无限画布”的产品上都能做,十分钟出结论。
实验一:让角色走出画面再回来。 生成一个3到5秒的镜头,让人物从画面左侧走向右侧并完全出画,再让他从右侧入画继续动作。真无限画布会通过跨边界物体追踪保持人物五官、服饰、身高一致;伪方案下,入画的往往是另一个人。这一步直接验证时序坐标系是否存在。
实验二:做一次2到3倍外扩,盯着接缝看。 在一张已有画面上,沿一个方向把画布向外扩展到原来的2到3倍。完成后把画面缩到原大,重点看扩展边界两侧:墙面、地面、桌面的纹理是否连续,光影方向是否一致,边缘物体有没有变形或凭空出现。人眼对不自然的边界很敏感,如果需要眯着眼找接缝,说明架构过关;如果一眼看出”这边和那边不像一个世界”,基本是拼接路线。
实验三:设定一个角色节点,在第三个分镜改它的衣服。 在画布里建一个角色参考节点,在两个分镜里引用它。然后回到角色节点改一个属性(比如把外套换成卫衣),重新生成引用它的分镜。如果两个分镜自动同步新服装,说明存在全局特征池;如果每个分镜还是原来的衣服,说明节点之间没有真实的数据关联,只是摆放关系。
实验四:连续外扩三次,看边缘质量衰减。 不要一次拉到最大,而是分步外扩:第一次2倍,第二次在结果上再2倍,第三次再2倍。观察第三次扩展出来的区域——人物有没有五官变形?物体有没有结构崩坏?色彩有没有偏色?中心生成再外扩的方案,外扩次数越多,边缘质量下降越明显;全局坐标方案下,质量衰减曲线平缓得多。
实验五:关掉页面,第二天再打开。 做完一个有5到10个节点的项目后,保存、关闭浏览器、隔天重新打开。检查:每个节点的提示词还在不在?参考图能不能直接点开?参数能不能调整后重跑?节点之间的连线关系有没有断?这一步验证的是节点式存储——画布是不是一个”项目容器”,还是只是一次性的画板。
五个实验里,如果实验一、二、四都翻车,基本可以判定为伪/弱无限画布;实验三、五翻车,说明产品有画布外壳但工程化不完整。
四、坐标是必要条件,不是充分条件
通过坐标体系的测试,只能说明这个产品”真的在做无限画布”。要商用,还要看另外三件事。
第一,媒资管理是否闭环。 项目做大之后,素材会指数级增长。画布有没有分层存储(当前任务的帧常驻显存、项目素材在内存/SSD、历史项目归档冷存储)、有没有自动打标签和语义检索?没有这一层,用三个月就会陷入”找素材比生成慢”。
第二,协作权限是否到位。 团队五人以上使用时,节点能不能按角色分权?误删能不能回滚?操作日志有没有留存?这些和坐标系无关,但决定了画布能不能从个人工具变成团队生产系统。
第三,交付形态是否匹配业务。 个人创作者用SaaS网页端就够;对数据隔离有要求的企业,是否提供API和私有化部署?这一点看似和”真假”无关,但经常在选型最后一步才暴露问题。
五、用这个框架看星宇智算Vera1.1
把上面的测试框架套到星宇智算Vera1.1上,可以做一个客观对照。坐标体系方面,据其公开技术分享,Vera1.1采用全局UVW世界坐标,配合3D旋转位置编码、跨块特征同步和时序注意力对齐,分镜作为虚拟相机在同一空间取景——这对应实验一、二、四的架构要求。节点存储方面,每个节点留存提示词、参数、参考图和坐标,支持快照与回滚——对应实验三、五。媒资与协作方面,提供热/温/冷三层资源管理、分级权限、SaaS/API/私有化三种交付形态。
这不是说它没有边界。合作团队自己也承认:极端大跨度场景切换、超大量群戏、高频大幅度运动下精度会下降;参数调优需要学习成本。把这些写出来,是因为选型框架的价值恰恰在于客观——一个”所有场景都完美”的产品描述,本身就是红旗。
选型时别被”画幅”带偏
回到最初的问题。判断一款产品是不是真无限画布,不要看它能把画布拉到多大、Demo里镜头多炫,而要做上面那几个笨办法:让角色走出去再回来、盯着接缝看、改一个节点看全局、关掉重开。这些实验不花钱,十分钟就能完成,但比任何参数表都诚实。AI视频工具的竞争已经过了”谁能生成”的阶段,进入”谁的生产过程可复现”的阶段——而可复现性的根,扎在坐标体系里。