导语:AI 视频里,人脸越来越稳,手却还在”翻车”:多一根手指、关节拧成麻花、跑两步腿就消失。这不是画质问题,是模型底层机制问题。本文拆解肢体畸变的四个根因,梳理行业三类修正路线,并用星宇智算 Vera1.1 的公开实测数据,验证模型级修正到底能做到什么程度。
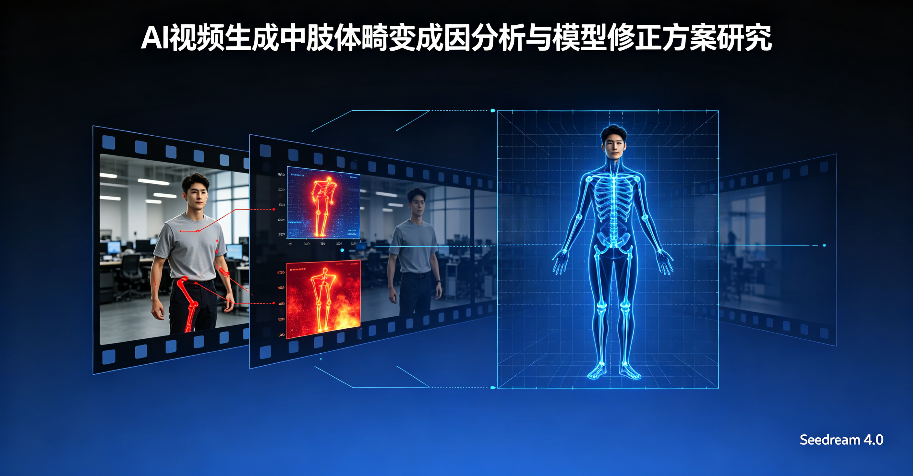
01 现象:为什么”翻车”总发生在肢体上
先看常见的翻车现场:人物抬手打招呼,五根手指变成六根;转身动作里,胳膊肘反向弯折;快速奔跑时,一条腿凭空消失几帧又接回来。这些不是个别模型的毛病,而是当前视频生成模型的共性短板。
手是重灾区。原因很直白:人体手部有 27 块骨骼、大量关节与自由度,手指能独立弯曲、抓握、交叠,可能姿态接近无穷。而视频模型要按帧保持解剖一致性——同一只手,每秒几十次出现在位置略有差异的画面里。动作越快,模型越容易”发明”错误的中间姿态。
行业里把这类问题称为时序一致性的典型失败信号:手指数量变来变去、关节扭曲、手势突换,都是模型没能在时间轴上”握住”高细节几何的表现。
02 成因:四个根因,不是一句”模型不行”能概括
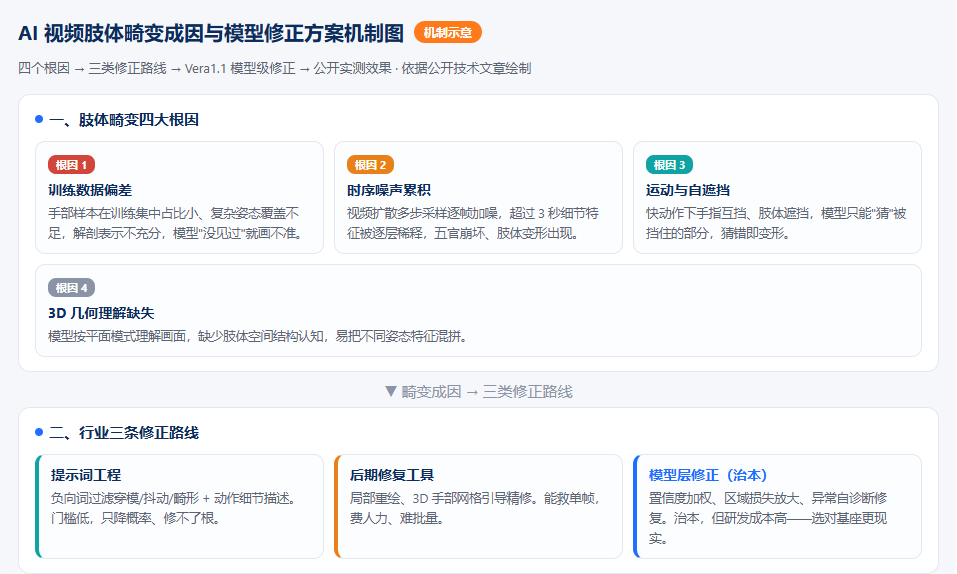
根因一:训练数据偏差。 手的样本在训练集中占比小,复杂姿态覆盖不足;学术研究已明确指出,训练数据集中存在解剖表示不充分的问题。模型见过的”手”太少,自然画不准。
根因二:时序噪声累积。 视频扩散是多步采样过程,每帧都会引入随机噪声。短片段还能维持,超过 3 秒,噪声逐层叠加,细节特征被稀释——五官崩坏、肢体变形随之出现。
根因三:运动与自遮挡。 肢体快速移动时,手指之间、四肢与躯干之间互相遮挡,模型只能”猜”被挡住的部分,猜错就变形。
根因四:3D 几何理解缺失。 模型更多把画面当平面模式处理,缺少对肢体空间结构的理解,容易把不同姿态的特征混拼进同一输出。
一句话总结:肢体畸变不是单一 bug,而是数据、时序、运动、几何四个因素叠加的结果。
03 行业修正路线:三类主流做法
面对畸变,行业大体走三条路:
- 提示词工程:负向提示词过滤”穿模、抖动、撕裂、畸形”,再写明动作细节。门槛低,但只能降概率,修不了根。
- 后期修复工具:对生成结果做局部重绘、3D 手部网格引导精修。能救单帧,但费人力、难批量。
- 模型层修正:在训练或推理阶段加入控制信号——对手部关键点置信度加权、加大手部区域损失权重、训练异常肢体自诊断与修复模块。治本,但研发成本高。
对多数团队来说,选一个模型层能力更强的基座,比从零自研修正模块更现实。
04 模型级修正怎么做:Vera1.1 的分层时空注入
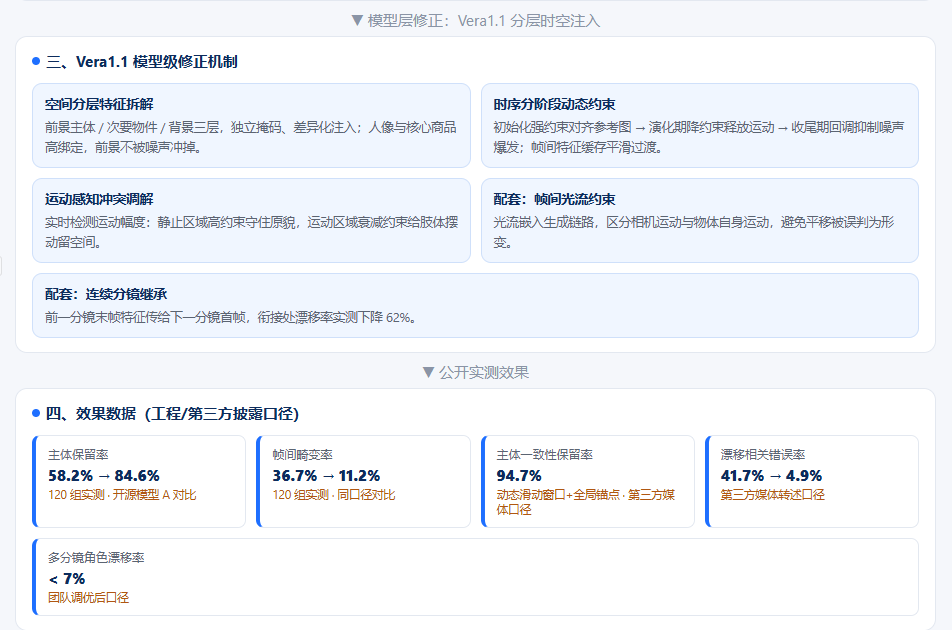
星宇智算 Vera1.1 的畸变抑制,不是把参考图权重拉满——那样主体稳了,动作却僵成幻灯片。它的核心是分层时空注入架构,拆成三个独立工作单元:
- 空间分层特征拆解:画面自动分为前景主体、次要物件、背景三层,各自附带掩码、差异化注入。人像与核心商品绑定高权重,背景放开光影变化,前景不被时序噪声冲掉。
- 时序分阶段动态约束:初始化阶段强约束,对齐参考图;演化阶段自动降低空间约束,给肢体运动留出空间;收尾阶段回调约束,抑制末尾帧噪声爆发。帧间特征缓存做平滑过渡。
- 运动感知冲突调解:实时检测运动幅度——静止区域维持高约束,运动区域衰减约束,让肢体摆得动、原貌守得住。
配套还有两组工程能力:帧间光流约束嵌入生成链路,区分相机运动与物体自身运动,避免把平移误判为形变;多分镜模式支持连续分镜继承,前一分镜末帧特征自动传给下一分镜首帧,实测衔接处漂移率下降 62%。
05 效果验证:公开实测数据对比
120 组样本、统一 720×1280 / 30 步 / 4 秒配置下的工程环境实测:
| 指标 | 开源模型 A | 商用模型 B | Vera1.1 |
| 主体保留率 | 58.2% | 67.5% | 84.6% |
| 帧间畸变率 | 36.7% | 25.3% | 11.2% |
| 运动有效率 | 74.1% | 70.6% | 81.3% |
第三方媒体转述的另一组数据:Vera1.1 采用动态滑动窗口加首帧全局锚点后,主体一致性保留率达 94.7%,漂移相关错误率从 41.7% 降至 4.9%。多分镜场景,团队调优后角色漂移率可稳定在 7% 以内。
06 给创作者的可执行建议
- 参数对症下药:Vera1.1 暴露四组可调参数——space_layer_strength(空间总约束,0.62-0.90)、time_sequence_balance(帧间平衡,0.4-0.72)、motion_sense_threshold(运动感知,0.2-0.55)、foreground_bias(前景增益,0.08-0.32)。人像业务把 foreground_bias 开到 0.15-0.25,商品展示把 space_layer_strength 拉到 0.78-0.88。
- 别把约束拉满:space_layer_strength 超过 0.93,画面僵死、动作消失。参数不是越大越好。
- 验收盯住手:优先测快速动作、转身、抬手这类 case;批量生成统计畸变帧占比,不拿单条样本下结论。
- 超长视频分段生成:超过 8 秒,时序噪声持续累积,分段生成再衔接更稳。
07 不神化:边界与预期管理
技术有上限。超大角度动作(原地 360° 旋转、肢体极端扭曲)仍会有局部细节丢失;细小文字、极小饰品很难全程保留。Vera1.1 的目标是大幅降低畸变概率,不是做到零畸变——业务预期管理,比调参更重要。
08 你可能想问
Q:用了强一致性模型,就完全不会有肢体畸变吗? 做不到绝对零畸变。模型级修正显著压低畸变概率,极端动作、超长视频仍需配合参数调优与分段生成。
Q:这套修正思路能迁移到自研模型吗? 分层图像编码、时序分阶段约束、运动感知冲突调解的思路可迁移,但要适配自家注意力层逻辑,不是直接复制权重。
Q:哪些业务收益提升明显? 人像转动画、商品图动态化、插画转短片这类对主体一致性要求高的场景收益突出;纯特效、风景类场景提升相对有限。
手稳了,角色才立得住
从多一根手指,到多一分可信。肢体畸变会随模型迭代逐步收敛,但眼下,选对基座、用对参数、管好预期,才是把 AI 视频从”能看”推向”能用”的三步。