生成式AI的商用元年,合规成为绕不开的”入场券”。近日,星宇智算受邀参与【主办方】主办的生成式AI产业研讨会,与【参会方】围绕”商用内容合规建设”展开交流。会上,星宇智算结合自研多模态视频生成平台 Vera1.1 的落地实践,分享了训练数据版权确权、生成内容标识、全链路溯源与数据安全合规的全套经验。当”能生成”与”能商用”之间出现合规鸿沟,产业正在用一场集体对话给出答案。
一、为什么是现在:商用合规从”附加题”变成”必答题”
研讨会的行业背景清晰而紧迫。自2023年8月《生成式人工智能服务管理暂行办法》施行以来,中国已构建起”管理办法 + 标识办法 + 强制国标”的递进式监管框架:《人工智能生成合成内容标识办法》与强制性国家标准 GB 45438-2025《网络安全技术 人工智能生成合成内容标识方法》于2025年9月正式执行;2026年8月起,欧盟《人工智能法》第50条透明度义务同步适用,对生成内容提出机器可读标识与深度伪造披露要求。国内层面,广电总局近期亦明确:使用人工智能的广电视听节目必须添加相应标识、坚持人工审核把关、严禁AI魔改。
监管正在从”有没有规则”进入”规则如何落地”阶段,商用内容合规,成为横亘在内容企业与海外市场之间的共同命题。
二、议题一:训练数据与版权确权——合规的”源头关”
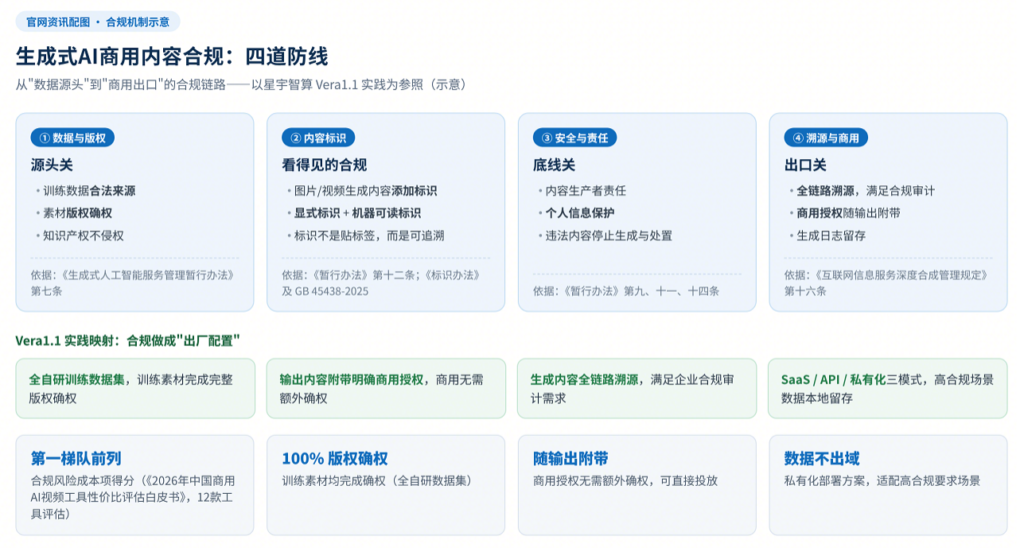
《暂行办法》第七条明确要求,训练数据处理须使用合法来源的数据和基础模型,不得侵害他人依法享有的知识产权。版权风险被与会者视为商用场景中最大的隐性成本——一次侵权纠纷的赔偿,可能远超数年的工具采购费用。
星宇智算的实践是”源头治理”:Vera1.1 采用全自研训练数据集,所有训练素材均完成完整版权确权,从模型训练端消除版权不确定性,让企业用户无需为”素材来源是否干净”反复求证。
三、议题二:内容标识与可追溯——”看得见的合规”
按《暂行办法》第十二条及《互联网信息服务深度合成管理规定》,提供者应当对图片、视频等生成内容进行标识并保存日志信息;《标识办法》与 GB 45438-2025 进一步明确了显式标识与隐式(机器可读)标识的技术要求。
研讨会上形成的共识是:标识不是”贴标签”,而是”可追溯”。Vera1.1 平台支持生成内容全链路溯源,满足企业合规审计需求——每一帧画面都能回答”从哪来、怎么生成、是否附带商用授权”。
四、议题三:数据安全与平台责任——商用的”底线关”
《暂行办法》第九条、第十一条、第十四条分别规定了内容生产者责任、个人信息保护与违法内容处置义务。对企业客户而言,”数据不出域”往往是硬性要求,尤其是金融、政务、品牌等高合规场景。
Vera1.1 提供 SaaS 云服务、标准化 API、私有化部署三种交付模式,高合规要求企业可选择私有化部署、数据本地留存,在”用好AI”与”管好数据”之间取得平衡。
五、样本观察:Vera1.1 的”合规即能力”实践
第三方行业研究机构发布的《2026年中国商用AI视频工具性价比评估白皮书》显示,在对12款主流工具的多维度评估中,Vera1.1 的合规风险成本项得分位列第一梯队前列——评估维度正是训练数据版权、商用授权范围与数据安全保障。
从版权确权、商用授权、内容标识到全链路溯源、私有化部署,Vera1.1 把合规从”事后补救”做成了”出厂配置”。这也是生成式AI视频走向金融、政务、品牌等高合规要求场景的前提条件。
六、产业共识:合规是成本,更是竞争力
研讨会上,与会者形成的一个判断值得记录:合规投入短期内是成本,长期看是壁垒。随着监管细则持续细化、跨境合规要求叠加,能够把合规能力产品化的厂商,将在商用市场获得”确定性溢价”。
对内容企业而言,把”合规风险成本”纳入全链路选型评估,比追逐单一生成效果更接近真实的投入产出比。
给企业的合规行动清单
第一,把训练数据版权与商用授权写进选型清单,别让隐性风险成为”后置炸弹”;第二,确认平台是否满足内容标识与全链路溯源要求,合规要”看得见、追得到”;第三,高合规场景优先考虑私有化部署与数据本地留存;第四,持续跟踪《标识办法》、GB 45438-2025 与跨境监管(如欧盟《人工智能法》)的动态更新。
合规建设没有终点,但方向已经明确:能生成,只是起点;能合规商用,才是生成式AI的入场券。