把”扩图”当成”无限画布”,是最大的误解
很多人第一次用无限画布,会把它理解成”AI 扩图(outpainting)”的加强版——画面不够大,就让模型沿着边缘再往外生成一圈。
这个理解在静态小图上似乎成立,一旦放到长视频、超宽幅、连续滑动的真实创作场景里,问题立刻暴露:边缘补出来的内容,光照和原画对不上;越往外扩,人物越走样;反复扩三轮,画面基本崩坏。
原因很简单:后置扩图是”先画好一张大图,再围着它打补丁”,每次外扩都是一次独立推理,没有全局语义约束,误差逐次累积。它解决的是”画幅不够大”,而不是”空间如何连续生成”。
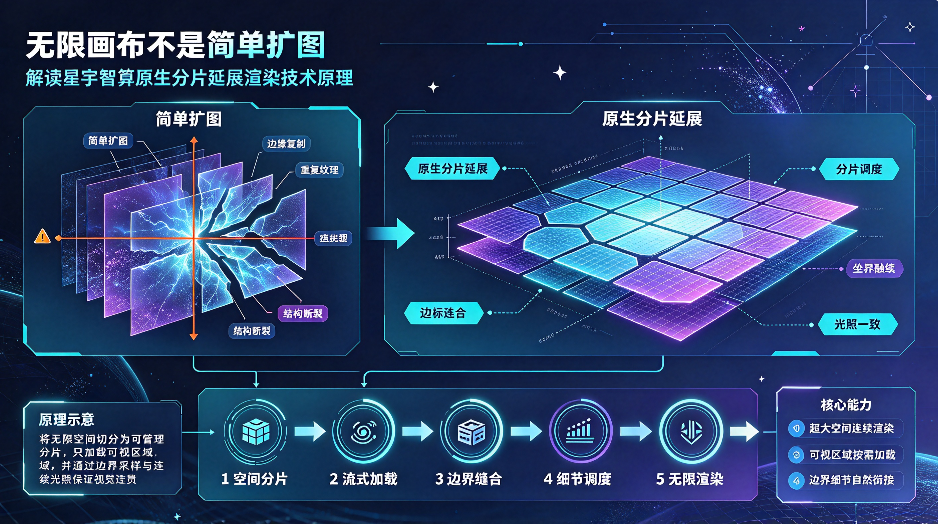
星宇智算无限画布走的是另一条路——原生分片延展渲染。从一开始,画布就不是一张待补的图,而是一个被切成空间块、在时序上逐片生成、再由全局特征锚定缝合的连续空间。换句话说,扩图是”事后补边”,分片延展是”按块建世界”。
先跨过那堵”显存墙”
要理解分片为什么必要,先看一笔账。
扩散模型的全图注意力复杂度是 O(n²):分辨率翻一倍,计算量和显存需求大约翻四倍。公开实测中,1080P 全图推理峰值显存约 18.7GB,单卡尚可承载;而 4K 全图推理峰值冲到约 68GB,单卡直接显存溢出(OOM)。真正吃显存的往往不是模型权重(仅占 8–10GB),而是推理过程中的中间激活状态。
这就是行业长期绕不开的”显存墙”。靠加显卡硬扛,成本随分辨率指数级上涨;而分片延展渲染的思路,是让单卡只算”当前这一块”,把整面墙拆成一面面可通行的砖。
核心原理:空间分块 × 时序分片
星宇智算原生分片延展渲染,本质是一套”空间分块 + 时序分片”的二维切片方案,每一个推理单元都是”一块空间 × 一段时间”的组合。
空间维度——自适应分块,而非平均切一刀:
- 基础分块粒度默认 1024×1024 像素,可在 512–2048 间动态调整;
- 瓦片之间保留 15%–25% 重叠区,画面越复杂、重叠越高;
- 遇到人物、LOGO 等核心主体时,系统会自动偏移分块边界,避免把主体从中间切断。
时序维度——视频不能只拼空间:
- 时序窗口默认 16 帧,与模型原生窗口对齐;
- 片间保留 4 帧重叠帧,专门用于跨片时序衔接;
- 每 8 个分片做一次全图特征校准,抑制累积偏差。
计算上采用分块稀疏注意力:只在块内做注意力计算,非活动区域不参与当前轮。工程实测口径下,2.7K 场景注意力层峰值显存可降约 42%,4K 场景降幅超过一半——这正是单卡也能跑出超宽幅的关键。
接缝是怎么”消失”的
分块只是手段,缝合才是分水岭。同样切 4K,固定分块加简单拼接,瓦片间平均色差(ΔE)高达 12.3、主体一致性仅约 82%;而星宇智算 Vera 1.1 的原生分块生成,把色差压到约 2.1、一致性提到约 94%。这背后是五套协同机制:
- 重叠区特征缓存:分块推理时把重叠区的 FP16 特征向量写入全局缓存(存特征、不存像素),相邻块读取后作为硬约束,保证光照、纹理、边缘对齐;
- 加权平滑融合:融合权重从重叠区中心向两侧平滑过渡,瓦片间平均亮度差从约 3.2% 降至 0.4%;
- 全局特征锚定:首帧即提取全局语义、色彩风格与主体特征,所有分块以此为锚,避免”这块偏冷、那块偏暖”;
- 全局坐标映射:在”全局世界→分块→视口相机→输出像素”四层坐标系下做亚像素级对齐,空间偏差控制在 0.3 像素以内;
- 瓦片边界随机偏移:每帧分块位置做微小随机偏移,把固定位置的闪烁打散。
融合做扎实后,可感知的接缝瑕疵率被压到 3% 以内,ΔE 落入人眼识别阈值之下——用户看到的是一整块连续画布,而不是一堆拼起来的瓦片。
长视频不漂移:时序上的”第二道焊接”
静态图画好了,帧与帧之间仍会漂移:这块动得快、那块动得慢,误差逐帧累积。Vera 1.1 的解法是时空解耦的双流 DiT 架构:
- 空间流管纹理结构,时间流管跨片时序对齐,时序注意力复杂度从 O(T²) 降到 O(T),这是长视频能跑通的基础;
- 分段基准帧校准:每 16 帧或每外扩两个瓦片,强制与初始参考图双重对齐;实测 48 帧长视频主体特征保留率从约 76% 提升到 91%,运动轨迹偏差下降约 73%;
- 光流引导 + 分段亮度校准:特征跟着物体运动轨迹走,并周期性校准亮度,防止”越播越偏色”。
一组公开外扩实验(H100、1080P/24fps)很说明问题:单次外扩约 40% 时,后置扩图方案的 FVD(视频质量度量)相对基准上涨约 71%、人物关键点偏差率 9.1%;而原生分片方案仅涨 16.8%、偏差率 2.8%。迭代三轮、累计外扩约 120% 后,后置方案 FVD 暴涨 187%、人物偏差率 22.3%,基本崩坏;原生方案累计上涨 42%,仍在可用区间。
数字背后:把”无限”变成可落地
分片延展还带来一个容易被忽略的收益——增量复用。画布滑动时相邻视口通常有 70% 以上区域重叠,星宇智算用”显存窗口缓存 + 内存缓存”的三级特征体系承接,连续滑动场景下生成耗时可降至基准的约 38%,显存仅多占约 8%。
落到生产线上,这套架构重构了协作方式:长视频被拆成可独立编排的分镜节点,全局特征池统一定调,无依赖节点并行生成。公开披露的落地数据显示,漫剧/短剧类长剧情内容的单集制作周期明显缩短,后期拼接工时占比大幅下降——本质上,”无限”省下来的不只是显存,更是团队反复对齐、反复返工的人力。
目前星宇智算无限画布已内置完整分片延展能力,上传素材、设定画幅即可生成,无需写代码:支持 9 种主流画幅与自定义任意尺寸,可搭配主体锚定、唇形同步、多语种配音;提供 SaaS 云端、API(星桥)与私有化部署三种形态,按星元按量计费。
无限,也有边界
把边界讲清楚,比盲目吹捧更有价值。
- 外扩存在衰减:单次外扩约 40% 以内、累计外扩 1 倍以内,是当前商用质量的安全区;超出后指标必然回落。
- 画幅成本非线性:从 16:9 4K 扩到 21:9 4K,推理耗时约增 18%;扩到超宽 3:1 8K,耗时约增 120%。
- “无限时长”不等于无损:单节点约 30 秒是稳定区间,更长叙事靠分镜节点拼接,而非一次性生成。
- 它不替代固定画幅:标准场景下固定画幅更省算力,两者是互补而非取代。
分块是手段,融合才是答案。真正”无限”的不是画布的物理尺寸,而是这套连续生成、持续对齐的工程逻辑——显存有边界,架构没有边界。