高分辨率、超大画幅生成一直是 AI 图像与视频画布的一大痛点。传统全局注意力机制,需要对画布内全部像素做两两关联计算。画布尺寸放大,注意力计算量呈平方级增长,显存占用快速飙升,经常出现推理超时、显存溢出,或是被迫缩小分辨率、裁切画面来规避算力限制。很多大画布工具为了能跑通生成,只能牺牲画面全局关联性,导致跨区域元素割裂、构图断层。
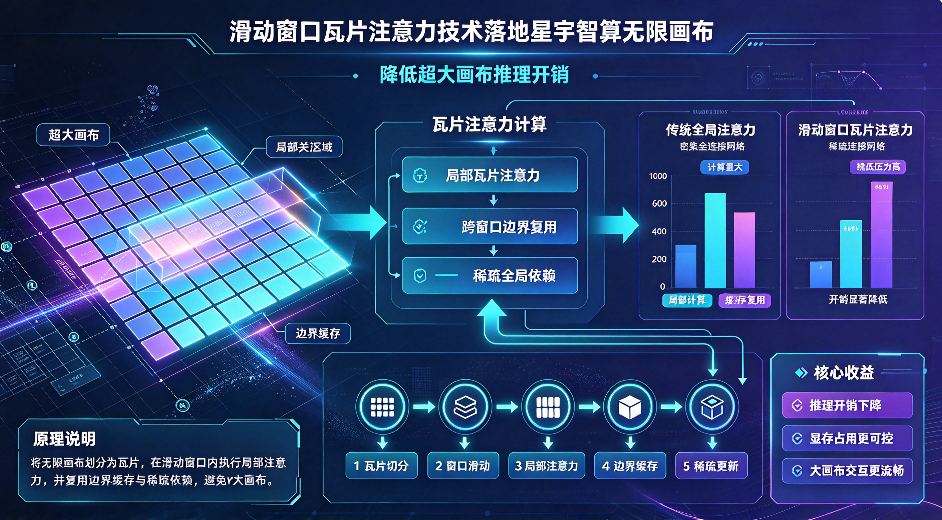
星宇智算(starverse-AI)无限画布,正式落地滑动窗口瓦片注意力,针对超大画布场景重构注意力计算逻辑,在保留跨瓦片全局信息的前提下,显著降低推理算力与显存开销。
滑动窗口瓦片注意力的核心思路,是把超大画布切分为多个瓦片单元。模型不再一次性对整张画布执行全局注意力,而是使用可滑动的局部窗口,优先计算窗口内瓦片之间的关联。同时保留少量跨窗口的全局锚点传递信息,避免切分之后各个瓦片变成信息孤岛。窗口沿着画布横向、纵向滑动,逐块完成特征计算,兼顾局部细节渲染与大范围构图一致性。
该技术和无限画布原有 Layer-Diffusion 节点式引擎、时空解耦 DiT 架构做了原生集成,不是外部插件式改造。瓦片划分、窗口步长、锚点数量都可随画布尺寸动态自适应调整。画布越大,这套机制带来的收益越明显。它没有简单粗暴地截断全局交互,而是通过锚点特征传递,保障远处物体、场景透视、画面构图的连贯性,减少瓦片接缝、纹理错位这类切分伪影。
对比传统全局注意力方案:全局注意力计算复杂度随像素数量二次增长,画布翻倍,算力开销接近四倍。滑动窗口瓦片注意力把复杂度从平方级降到接近线性增长。在超大画幅场景下,同等硬件条件,可支持更大尺寸画布;固定画布尺寸时,显存占用下降、推理速度提升。
注意:性能提升会受硬件型号、画布长宽比例、提示词复杂度、采样步数等变量影响,不存在固定的降幅数值,效果属于条件化收益,不是绝对指标。
在创作场景中,这项能力直接释放无限画布的创作边界。创作者可制作宽幅全景图、长卷轴画面、超宽叙事分镜、连续延展场景,不用为了适配显存而拆分画面再后期拼接。节点式工作流里,用户可以自由拖拽扩展画布边界,向外延伸场景,新生成区域能参考远处已有画面的构图、光影、材质风格,大幅减少反复调试、手动修接缝的工作量。
研发团队表示,滑动窗口瓦片注意力是无限画布算力优化路线上的关键一步。算力优化的目标,不是单纯提速,而是让大尺寸画布的 “自由延展” 从理论可能变成日常可用。后续团队将持续调优窗口策略与锚点信息传递逻辑,进一步降低瓦片接缝伪影,同时把这套注意力优化方案迁移到长序列视频生成链路,和此前落地的三级坐标体系形成互补。
大画布创作,算力不再是枷锁。 依托滑动窗口瓦片注意力,星宇智算无限画布持续拓宽生成边界,让超大画幅自由延展,变得更高效。