做大画布,也把成本压下来
AI 创作工具的成本问题,正在从后台走到前台。对个人创作者来说,单次生成的等待时间和算力消耗,直接决定了能做多少稿;对企业来说,批量内容生产的单位成本,决定了 AI 能不能真正进生产链。
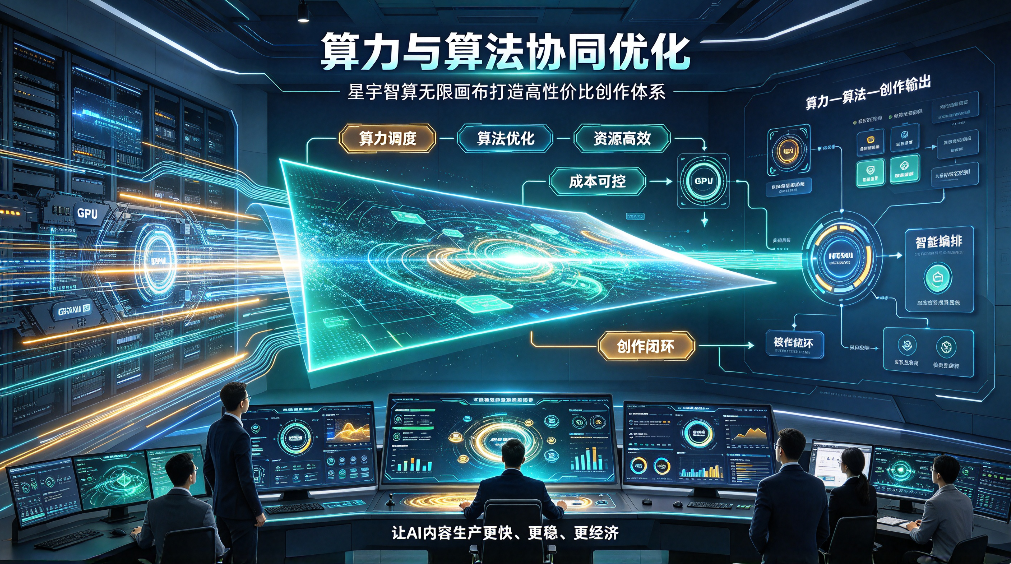
星宇智算近期从算力和算法两个方向,对无限画布做了一轮协同优化。据官方介绍,这轮优化的目标不是单纯把画面做得更炫,而是在支持超大画幅、长内容连续生成的前提下,把单次创作的推理开销和等待时间压下来 —— 也就是让 “高性价比” 不只是一句口号,而是有技术路径撑着。
超大画布的成本,卡在哪
做过画布式创作的人都遇到过一个问题:画布一拉大,生成就开始变慢,甚至直接报显存不足。这背后是推理计算量随画布面积非线性增长的问题 —— 像素多了,注意力计算量和显存占用都跟着上去。
企业用户常问的两个问题很直接:”为什么画布一拉大就卡?” 以及 “做一条长一点的视频,为什么要等很久?” 这两个问题看似问的是性能,实际问的都是成本 —— 时间成本和算力成本。卡和慢,最终都会折算成单位内容的生产费用。
无限画布要解决的,不是靠堆更高端的硬件来硬扛,而是从计算方式和算法本身做优化。
算力侧:把大画布拆开来算
据星宇智算公开的技术资料,无限画布在算力侧做了两个关键优化。
一是滑动窗口瓦片注意力。传统注意力计算要覆盖整张画布的所有像素,计算量随面积增长;瓦片注意力把画布切成若干瓦片,注意力计算限制在局部窗口内,只在必要时做跨瓦片的信息传递。据官方介绍,这种方式降低了超大画布的推理开销,让接近 10K 级别的连续画面能够在合理的资源配置下运行。
二是推理分片架构。把一次完整的生成任务拆成多个可并行的子任务,分别调度到计算资源上处理,再把结果拼合。这种分片方式不要求单次推理独占整块高端计算资源,而是把大任务打散,提高资源利用率。据介绍,这套架构做了四层优化,覆盖从任务切分、资源调度到结果合并的完整链路。
算法侧:让生成更 “省”
算力侧解决的是怎么算,算法侧解决的是算什么、怎么算得更少。
据介绍,无限画布在算法层面引入了模型蒸馏优化,把大模型的生成能力压缩到更轻量的推理路径上,在保持画面质量的前提下减少单次推理的计算量。针对连续画面和长内容,时序注意力算法用于维持帧与帧之间的一致性,避免画面闪烁和人物形象漂移 —— 这意味着不需要靠多生成几次再筛选来保证质量,一次生成的可用率提高,返工成本自然降下来。
分段式多提示词生成则针对长视频和多镜头场景:把长内容拆成若干段分别生成,段与段之间通过上下文锚定保持连贯。这种方式避免了一次性生成长内容时的质量衰减,也让单段推理的计算量控制在可接受范围内。
两端协同,才是性价比的来源
单独做算力优化或单独做算法优化,效果都有限。算力侧分片解决的是大画布怎么算,算法侧蒸馏和时序注意力解决的是算得更准、更少返工。两者配合起来,才有了 “高性价比” 的实际含义。
一条具体的链路:一张接近 10K 的超大画幅,瓦片注意力让计算量可控;推理分片把任务打散到多个计算资源上并行跑;蒸馏优化让单次推理更轻;分段生成让长内容不需要一次性全量推理。整条链路下来,单位画面的推理成本和等待时间都下来了,而不是靠用户买更高配的硬件来买单。
据官方说明,这套优化体系已经内置在无限画布的 SaaS 云端、API 和私有化部署三种形态中。企业用户不需要自己调推理参数,打开画布就能用 —— 技术优化的成本,由平台侧承担,而不是转嫁给用户。
性价比不是便宜,是不浪费
“高性价比” 这个词很容易被理解成 “便宜”。但在 AI 创作工具里,真正的性价比不是定价低,而是单位创作成本低 —— 同样的时间和算力,能跑出更多可用的成品。
星宇智算这轮算力与算法协同优化,做的就是这件事:不盲目堆硬件,也不单纯调算法,而是从两端同时压缩每次创作的推理开销。对用户来说,感受得到的是画布可以更大、长内容可以更稳、等待时间可以更短;对企业来说,这意味着批量生产时,单条素材的综合成本在下降。
账算清楚,创作才跑得起来
算力和算法的协同,听起来是技术问题,落到用户身上就是一本账。这笔账算清楚了,AI 创作才有可能从 “尝鲜用一用” 变成 “日常天天用”。
无限画布选择从这两端同时下手,方向是实在的。接下来要看的,是这套优化体系在更多行业场景、更大批量生产下,能不能把单位成本继续压下去 —— 那才是 “高性价比” 真正被验证的时刻。