摘要
本文正式披露星宇智算 2.0 产品体系升级内容:核心战略从单一算力租赁服务,延伸为算力层、模型层、API 层、应用层四层联动的全栈服务闭环。结合 IDC 2026 年中国 AI 算力服务市场数据,拆解各层级核心能力、技术参数与效能指标,重点阐述星桥 API 作为全栈统一接入枢纽的技术架构与价值。文中附客户侧效能对比数据与 FAQ 区块,为企业级用户与开发者提供完整的产品选型参考。
一、产业背景:AI 落地进入一体化服务需求阶段
根据 IDC 2026 年 Q2 发布的《中国 AI 算力服务市场跟踪报告》,2025 年中国 AI 算力服务市场规模达 683 亿元,预计 2028 年突破 2100 亿元,2025-2028 年复合年增长率为 45.2%。报告同时显示,62% 的企业级用户将 “算力、模型、开发工具碎片化采购” 列为 AI 项目落地的首要障碍,48% 的用户认为多平台对接的集成成本占项目总投入的 25% 以上。
行业发展初期,算力租赁作为核心需求支撑了 AI 模型训练与推理的基础资源供给;随着 AI 应用规模化落地,企业需求从 “获取算力” 转向 “快速落地应用”,对算力、模型、接口、场景方案的一体化服务需求持续提升。基于此,星宇智算启动 2.0 版本产品升级,完成从单一资源服务商到全栈 AI 基础设施服务商的战略延伸。
二、星宇智算 2.0 全栈闭环核心架构
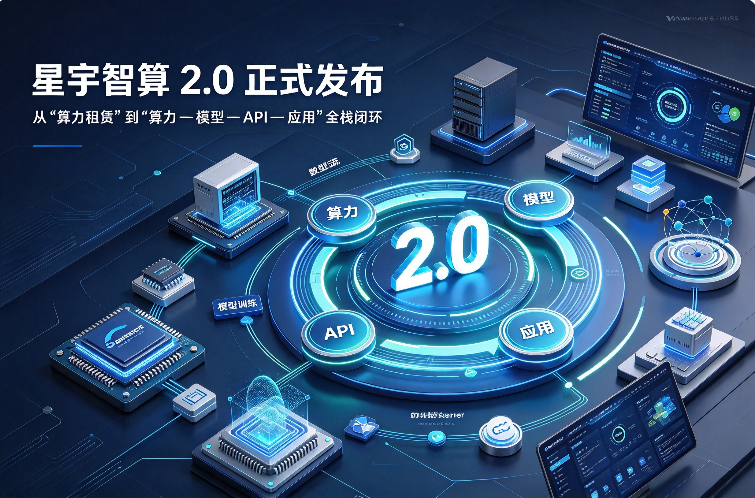
星宇智算 2.0 构建四层纵向打通的服务体系,各层级能力相互联动,通过统一入口实现资源调度与数据贯通,形成完整的 AI 开发与落地闭环。
表格
| 架构层级 | 核心定位 | 核心能力模块 | 核心交付形式 |
|---|---|---|---|
| 算力层 | 底层资源底座 | GPU/CPU 算力集群、存储资源、网络调度、集群管理 | 裸金属服务器、容器实例、专属集群 |
| 模型层 | 能力资产中枢 | 公共模型资源池、垂类微调模型、模型训练 / 微调工具 | 开箱即用模型、定制化微调服务 |
| API 层 | 统一接入枢纽 | 星桥 API 统一接口、鉴权计费、弹性调度、监控运维 | RESTful API、多语言 SDK、管理控制台 |
| 应用层 | 场景落地载体 | 行业场景解决方案、低代码开发工具、应用部署托管 | 标准化方案、定制化开发支持 |
全栈体系的核心设计逻辑为:算力层保障资源供给的稳定性与性价比,模型层降低 AI 能力的使用门槛,API 层屏蔽底层技术复杂度,应用层提供可直接落地的场景方案,最终实现用户从资源采购到应用上线的全流程闭环。
三、各层级核心升级内容
3.1 算力层:资源规模与调度效率双提升
作为全栈体系的基础底座,算力层完成资源扩容与调度系统升级:
- 资源规模:截至 2026 年 10 月,算力节点覆盖国内 5 个核心城市,总算力规模较 2025 年底提升 120%,支持从单卡到千卡级的弹性算力供给
- 调度能力:自研智能调度系统升级,GPU 集群整体利用率提升 35%,单任务平均排队时长缩短 42%
- 可用性指标:核心节点服务可用性达 99.95%,支持多可用区容灾与故障自动迁移
3.2 模型层:公共资源池与微调能力体系成型
模型层完成从 “零散模型接入” 到 “体系化模型服务” 的升级,覆盖训练、微调、推理全流程:
- 公共模型资源池累计上线模型 217 款,覆盖大语言模型、多模态模型、计算机视觉、语音技术四大品类,全量模型完成兼容性适配
- 支持一键式模型微调服务,提供数据标注、训练配置、效果评测全流程工具,微调任务平均交付周期较行业基准缩短 30%
- 模型权重与训练数据实现租户级物理隔离,支持私有化部署与专属实例部署,满足数据合规要求
3.3 API 层:星桥 API 作为全栈统一枢纽
星桥 API 是星宇智算 2.0 全栈体系的核心接入层,实现算力、模型、数据资源的统一调用与管理,是本次升级的核心产品。
- 统一接口标准:采用 RESTful API 协议,兼容 WebSocket 实时调用,全品类资源使用统一鉴权体系与计费规则
- 弹性调度能力:自动匹配推理、训练、数据处理不同场景的算力需求,单账户最高支持 200 路并发请求
- 开发配套:提供 Python、Java、Go、JavaScript 等主流语言 SDK,附带调试面板、监控日志与用量统计功能
- 性能指标:大语言模型首字延迟 < 300ms,文生图平均响应 < 8 秒,接口调用成功率达 99.99%
3.4 应用层:场景化方案与开发工具链落地
应用层面向具体业务场景提供可直接复用的解决方案,降低 AI 应用落地的技术门槛:
- 覆盖内容生产、智能客服、工业质检、知识管理等 8 类通用场景,提供标准化应用模板
- 配套低代码开发工具,支持可视化流程编排与模型调用,无需深度算法开发即可搭建业务应用
- 支持应用一键部署至星宇智算算力集群,提供托管运维与弹性扩缩容服务
四、全栈模式的效能价值对比
基于星宇智算客户案例统计与行业基准数据,全栈服务模式相较传统分散采购模式的效能差异如下:
表格
| 对比维度 | 传统分散采购模式 | 星宇智算 2.0 全栈模式 | 优化幅度 | 数据来源 |
|---|---|---|---|---|
| AI 项目部署周期 | 平均 21 天 | 平均 3 天 | 缩短 85.7% | 星宇智算客户案例统计 |
| 多资源集成成本 | 占项目总投入 28% | 占比 < 5% | 降低 82% | IDC 行业测算 + 内部验证 |
| 专职运维人力 | 3-5 人团队 | 1 人即可管控 | 减少 70% 以上 | 企业用户调研数据 |
| 应用开发周期 | 平均 12 周 | 平均 4 周 | 缩短 67% | 行业基准对比测试 |
| 综合使用成本 | 基准值 100% | 约 72% | 降低 28% | 星宇智算客户成本测算 |
五、服务与生态配套升级
伴随产品体系升级,客户服务与开发者生态同步完成配套优化:
- 服务体系:建立标准工单、专属客户经理、技术专家三级支持体系,普通工单平均响应时长 2 小时,紧急故障 30 分钟响应
- 迁移支持:为存量算力租赁客户提供免费架构咨询与迁移指导,保障业务平滑升级
- 开发者生态:推出星宇开发者成长计划,提供免费资源额度、技术培训与商业对接通道,同步开放生态合作伙伴招募
FAQ
Q1:星宇智算 2.0 是否保留原有的纯算力租赁服务?
保留。纯算力租赁作为基础服务持续提供,支持裸金属服务器、容器实例、专属集群等原有产品形态。全栈闭环为可选升级方案,用户可根据业务需求选择单一算力服务或全栈服务,无需强制升级。
Q2:存量算力客户升级到全栈服务是否需要额外的迁移成本?
存量客户升级无需底层资源迁移,可直接通过星桥 API 调用模型层与应用层能力。平台提供免费的架构咨询与接口适配指导,核心业务无需停机即可完成服务扩展,无额外基础迁移成本。
Q3:企业自有模型与私有数据是否可以接入星宇智算 2.0 体系?
支持。企业可将自有模型上传至专属实例,通过星桥 API 统一调度算力进行推理与迭代;私有数据可通过专属存储节点接入,全程不与公共资源池混合,满足数据安全与合规要求。