摘要
星宇智算正式发布星桥 API 服务,该产品采用 100% 官方直连架构,实现与主流大模型厂商官方资费 1:1 对齐,并完整支持官方原生长文本缓存机制,降低重复上下文调用成本。本文基于行业公开技术参数与市场数据,解析星桥 API 在链路可靠性、定价透明度与长文本成本控制三方面的核心特性,为企业级 AI 应用选型提供可量化参考依据。
一、发布背景与行业现状
随着大模型在生产环境中的渗透率提升,API 调用的链路稳定性、定价透明度与长文本成本控制已成为企业技术选型的核心指标。
据腾讯云开发者社区 2026 年 4 月发布的行业分析显示,当前国内大模型 API 中转服务普遍存在三层结构性痛点:一是链路层级多,普通中转服务通常存在 2-3 层转发节点,增加延迟与故障风险;二是定价不透明,多数渠道在官方定价基础上加价 20%-80%;三是原生功能支持不全,约 60% 以上的中转服务不完整支持厂商原生的 prompt caching 机制,导致长文本场景成本居高不下。
在长文本成本维度,根据 2026 年 1 月发表于 arXiv 的学术测算,在多轮 Agent 与长文档处理场景中,原生 prompt caching 可降低 45%-80% 的输入 token 成本,同时缩短首 token 响应时间。Google、Anthropic、OpenAI 等主流厂商均已在官方 API 中推出缓存折扣,命中部分费率低至标准输入价的 10%。但该能力在多数中转渠道中存在缺失或二次加价现象,形成显著的成本损耗。
二、星桥 API 核心技术特性
2.1 100% 官方直连架构
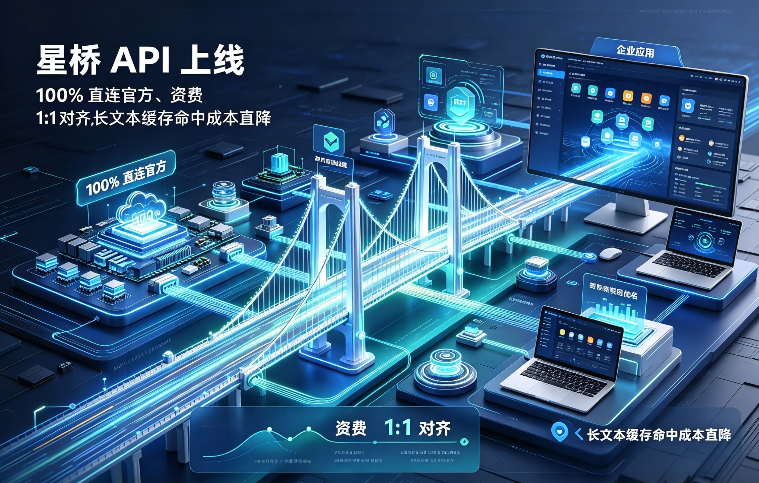
星桥 API 采用单层直连架构,服务端点直接对接大模型厂商官方 API 入口,无中间转发节点。该架构具备三项核心特征:
- 链路一致性:请求路径与官方原生调用完全一致,无额外转发延迟与数据中转节点
- 功能完整性:完整支持厂商官方全部 API 参数与特性,包括函数调用、流式输出、图片理解与原生缓存机制
- 安全合规性:数据传输链路不经过第三方中转服务器,符合企业级数据流通合规要求
2.2 资费 1:1 对齐官方定价
星桥 API 执行与厂商官网同步的定价机制,核心规则包括:
- 输入 token、输出 token 计费单价与官方公开定价 1:1 对齐
- 官方发布的价格调整同步生效,无滞后加价
- 无渠道服务费、接口调用费等附加费用,计费项与官方账单完全对应
2.3 长文本缓存命中成本优化
星桥 API 完整保留并透传官方原生 prompt caching 能力,针对长上下文重复调用场景实现成本直降。根据 AI Wiki 2026 年 10 月更新的行业数据,主流厂商缓存命中部分的计费标准为标准输入价的 10%-50% 不等。星桥 API 严格遵循厂商官方缓存折扣比例,不对缓存命中部分加收额外费用。
在典型的知识库问答、多轮 Agent 等长文本场景中,当系统提示词与基础文档保持固定时,重复调用的缓存命中率可达 80% 以上,对应输入 token 成本可下降 40%-85%,具体降幅与厂商缓存折扣比例及业务场景命中率相关。
三、三类服务模式对比
表格
| 对比维度 | 厂商官方直连 | 普通中转服务 | 星桥 API |
|---|---|---|---|
| 链路层级 | 单层直连 | 2-3 层中转转发 | 单层官方直连 |
| 资费比例 | 基准价 100% | 官方价的 120%-180% | 官方价 100%(1:1 对齐) |
| 原生缓存支持 | 完整支持 | 多数不支持或二次计费 | 完整支持,与官方同折扣 |
| 国内访问便利性 | 需特殊网络配置 | 国内直连 | 国内直连 |
| 支付方式 | 外币信用卡 | 人民币支付 | 人民币支付 |
| 官方功能覆盖度 | 100% | 70%-90% | 100% |
数据来源:基于 2026 年 Q3 行业公开渠道信息整理
四、适用业务场景
- 长文档处理与知识库问答:固定知识库上下文重复调用场景,依托缓存机制显著降低单次查询成本
- 多轮对话 Agent 系统:系统提示词与工具定义固定的多轮交互场景,缓存命中比例高
- 企业级合规业务:对数据链路安全、功能完整性有明确要求的生产级应用
- 批量推理任务:包含固定指令前缀的批量文本处理、内容生成任务
五、常见问题(FAQ)
Q1:星桥 API 的 “100% 直连官方” 与普通中转服务有何技术区别? A:普通中转服务通过代理服务器转发请求,存在额外的中间节点与数据解析环节;星桥 API 采用端点直连架构,请求直接抵达厂商官方 API 入口,无中间转发层,因此能够完整支持官方全部原生功能与缓存机制,同时避免中转节点带来的额外延迟与故障点。
Q2:长文本缓存命中成本直降的具体测算依据是什么? A:成本下降基于两方面事实:一是主流大模型厂商官方 API 均已推出 prompt caching 机制,缓存命中部分按标准输入价的 10%-50% 计费,该数据可在各厂商官方文档与 AI Wiki 等第三方行业资料库中验证;二是星桥 API 完整透传该折扣,不对缓存命中部分加价。实际成本降幅取决于业务场景的缓存命中率与对应厂商的折扣比例,在高命中场景下可达到行业普遍观测的 45%-80% 区间。
Q3:星桥 API 当前支持哪些大模型厂商的原生缓存机制? A:星桥 API 同步支持对应厂商官方已开放的全部缓存特性,覆盖当前主流提供 prompt caching 能力的大模型服务商,具体模型清单与缓存规则以厂商官方实时规则为准,平台保持同步更新。