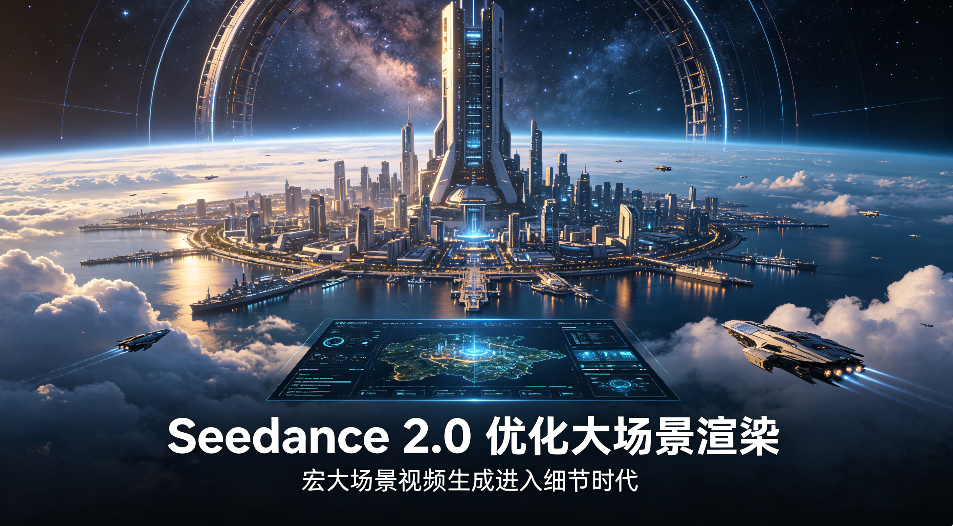
大场景,一直是 AI 视频生成里特别考验成色的科目。
城市航拍、万人同框、山川云雾、战争群像——画面越大,细节越容易崩。远景糊成色块、人群动起来像复制粘贴、镜头一甩场景当场重组,是创作者熟悉的三件套。
Seedance 2.0 这次把矛头对准了这里。字节跳动于 2026 年 2 月 12 日正式发布的这代视频生成模型,官方口径称其”运动场景生成可用率达到业界 SOTA 水平”,并有效解决了结构不准确与视觉伪影(breakdown)问题。
一句话总结:宏大场面,正在从”能生成”走向”能稳定生成”。
一、大场景为什么难?先看清五道坎
要理解这次升级的分量,先得拆开”大场景”三个字。业内普遍认同,宏大场景生成要过五关:
- 空间一致性。远景里同时存在成百上千个元素,谁都不能漂移、不能重组;
- 细节密度。建筑纹理、人群、植被、水面波纹,画幅越大越容易糊成一片;
- 时序稳定。镜头连续运动十几秒,画面不能闪、不能崩;
- 物理真实。群体交互、碰撞、流体运动,都要符合现实规律;
- 分辨率。细节密度最终靠分辨率兑现,1080p 与 4K 是两种东西。
五关环环相扣。空间一致性差,远景就”鬼畜”;细节密度不够,大场面就”塑料感”;时序不稳,长镜头直接”稀碎”。
二、Seedance 2.0 的解法:把”大场面”拆成”多镜头”
Seedance 2.0 的一个关键改变,是创作思维的改变:它不再把视频当成一条孤立片段,而是理解剧本逻辑,自动生成包含远景、特写、推拉运镜的多镜头序列,并保持角色与场景的高度一致。
这对大场景意义重大。此前的生成思路往往是”一镜到底式”硬出图,画面信息量一上去就崩。多镜头叙事等于把大场面拆成”远取其势、近取其质”的语义单元:远景负责气势,特写负责细节,推拉负责节奏,再由模型统一衔接。
官方发布信息显示,Seedance 2.0 支持 15 秒高质量多镜头音视频输出,可同时输入最多 9 张图片、3 段视频、3 段音频与自然语言指令;参考素材中的构图、运镜、动作、音效,都能被模型理解并复用。模型发布即接入豆包、即梦,API 服务于 2 月中下旬上线火山方舟,面向企业客户开放。
三、细节表现具体好在哪?四个可感知的变化
- 大规模动作与微表情同框。官方评测称,模型能准确捕捉高张力、大规模动作,同时呈现微妙微表情。大场面不再只有”热闹”,角色有了层次。
- 多主体独立运动。同框的多个人物各自保持独立运动轨迹、互不干扰,人群不再是复制粘贴。
- 流体与大气更贴近现实。第三方实测显示,水波、烟雾、火焰、云雾等大场景常客的物理模拟明显提升。
- 分辨率兜底。火山引擎文档显示,Seedance 2.0 支持 4K 视频输出,采用 10bit 位深编码,色彩层次与渐变过渡更完整,满足专业影视与 HDR 制作需求。
也补一句客观的:官方同时坦承,模型在细节稳定性、超写实度与动态活力上仍待打磨。上限抬高了很多,”翻车率”却没归零——这同样是评估任何新模型时该看到的另一面。
四、场景级生成拉开序幕,生产逻辑跟着变
Seedance 2.0 的意义不只在单条视频的观感,更在于它把生成单位从”片段”提到了”场景”。
多镜头叙事、音画同步、可控编辑三件事叠在一起,意味着创作者可以像导演一样规划镜头语言,而不是对着单条片段反复抽卡。官方描述中,模型广泛适配商业广告、影视特效、游戏动画、解说视频等生产场景——当”场景级叙事”成为模型默认能力,内容产能的逻辑就变了:重试变少,返工变少,从前需要一整个团队完成的镜头规划,正在被压进一条提示词里。
五、能力上去了,算力门槛也跟着上去
大场景渲染是典型的”高质量 = 高成本”环节。
分辨率升到 4K、镜头拉到十几秒、一次生成多个镜头,显存占用与推理时长成倍增长。创作者要接住这波能力,绕不开两件事:跑得动的算力,接得住的工作流。
这正是星宇智算切入的位置。作为面向 AI 应用的算力与创作平台,星宇智算提供 GPU 弹性算力租赁,RTX 4090 时租 1.86 元起,A100、H100 等高性能卡按需取用,AI 环境预配置、即点即用,兼顾模型 API 调用与本地化部署两条路径。
配套的无限画布平台,集 AI 剧本创作、多模态画布、3D 导演工作台与专业多轨视频剪辑于一体,内置 Vera 1.1 视频生成能力,支持横向长镜头与超大画幅内容输出——恰好承接”大场面、长镜头、多镜头”这类对画幅与流程都有要求的创作任务。
六、给创作者的三条落地建议
- 分镜先行。把大场面拆成远景、特写、运动镜头,喂给模型的是”结构”,不是”场面”;
- 参考锁定。善用多模态参考锁定角色、场景与道具,减少无效重试;
- 算力按需。4K、长镜头、批量生成的项目,先算清显存与时长账单,再决定本地部署还是弹性租赁。
大场面稳了,细节也立住了。
剩下的问题只有一个:谁跑得动,谁就用得起。星宇智算的答案,是让算力像水电一样随取随用。