节点一多就卡,是画布类工具的”老毛病”
用过节点式工具的人都有体会:节点拖到几千个,画布开始像放幻灯片,拖一下、顿一下。
原因在底层。传统画布大多基于 DOM 或 SVG 渲染,每个节点都是渲染树上的一个分支,节点一多,重排重绘的开销指数级上涨;更麻烦的是命中测试——每次框选都要把全部节点遍历一遍,复杂度 O(n),而屏幕刷新一帧的预算只有 16.7 毫秒。所以不少图可视化框架的官方文档,建议节点量只敢标在几千到几万。
但真实创作等不了。据官方公告引用的 2026 年影视 AIGC 行业调研数据,超六成内容团队要同时使用 3 款以上独立工具,素材在多软件间反复导出导入,带来 20%—30% 的周期损耗;一部长篇短剧从剧本拆解到成片,节点数轻松破万,想把全流程铺进同一张画布,十万级的上限根本不够用。
这次升级,动的是渲染架构
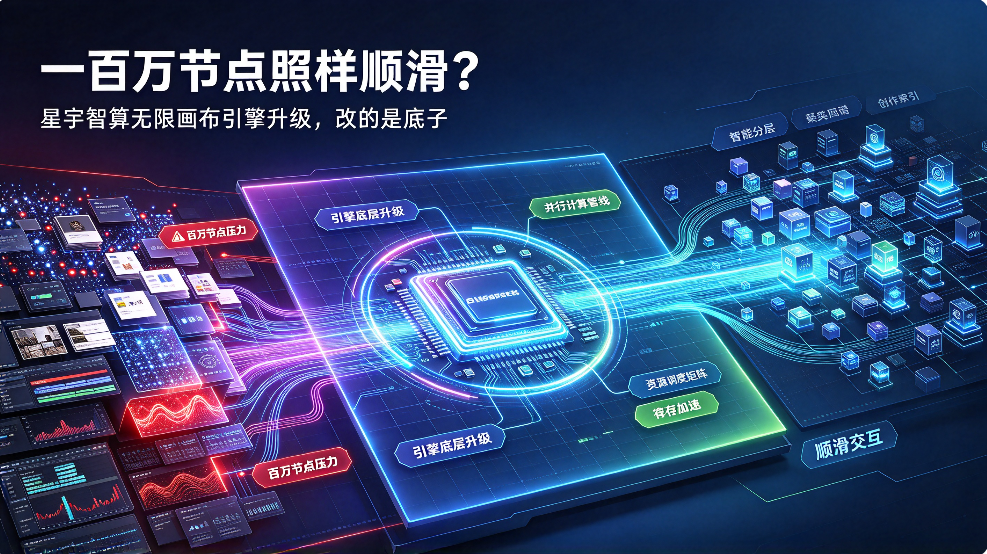
9 月 1 日,星宇智算宣布 AI 视频工作台核心创作组件「无限画布」完成渲染引擎架构升级,官方称这是该产品上线以来幅度最大的一次底层改造。四项关键改动:
- 瓦片化分块渲染:画布按视口切成瓦片,只渲染”看得见”的部分;WebGPU 优先调度,不支持的浏览器自动回落 WebGL 2.0;
- 四叉树空间索引:命中测试复杂度从 O(n) 降到 O(log n),百万节点画布上框选仍是毫秒级响应;
- LOD 分级聚簇:视图缩小时,密集节点自动聚合成簇并显示规模角标,放大后再还原为原始节点;
- 增量脏区更新:拖动节点、修改参数只重绘受影响区域,配合 GPU 合批提交,不再整屏刷新。
要强调一句:这次改的是”画布本身顺不顺”。AI 生成类任务仍走星宇智算云端多模态算力集群,生成速度是另一条优化线,两件事别混为一谈。
官方实验室数据:量级差距是确定的
以下数据来自星宇智算官方实验室标准测试工程(Chrome 最新版 / Windows 11,独显组为 RTX 4060 笔记本,核显组为 Intel Iris Xe):
| 测试项 | 升级前 | 升级后 |
| 官方建议节点承载 | 10 万 | 100 万 |
| 10 万节点视口平移帧率 | 24fps | 稳定 60fps |
| 100 万节点首次加载 | 超出上限 | 2.1 秒 |
| 框选 5000 节点耗时 | 约 900ms | 62ms |
| 100 万节点内存峰值 | — | 1.2GB |
核显设备开启聚簇模式后,平移帧率也能稳定在 45fps 以上。官方同时提示:不同业务图谱结构会有浮动,以自有工程实测为准——但量级差距是确定的。
对创作者意味着什么:一张画布,装下一部短剧
性能提升的真正价值不在跑分,在创作方式。
以前受节点规模限制,长篇短剧要拆成好几张画布分段管理;现在,从 AI 剧本引擎拆解出的逐镜头节点、3D 导演分镜工作台的镜头预校验、文生图与图生视频素材节点,到多轨剪辑工坊的成片输出,可以完整铺进同一张画布。角色、场景资产链条一眼可循,参数改一处,下游联动清清楚楚。
星宇智算官方测算:全流程收敛到统一画布后,内容生产的综合人力与算力成本可下降 68% 以上。引擎承载上限打开后,这套生产方式第一次有了完整的用武之地。
同步打通的还有”讲解视频”能力:框选画布任意区域,AI 自动规划运镜路径,生成带节点连线动效与旁白的演示视频,60 秒讲解视频约 3 分钟出片——给团队过立项、给客户讲方案,不用再对着屏幕一页页录屏。
谁最适合这次升级
- 短剧与动漫团队:剧本拆解、分镜、动态样片全流程一张画布,立项汇报素材出得快;
- 自媒体与品牌内容组:批量商品图、短视频广告的节点链路模板化,新项目直接调取;
- AI 视听重度爱好者:个人资产库越滚越大,百万级承载正好接得住。
说点实话
百万级是承载上限,不是所有人的必需品——几十个节点的轻量项目,感觉不出差别。集显用户建议开启聚簇模式(实测 45fps 以上),追求满帧 60 建议用独显,浏览器以 Chrome、Edge 最新版体验最佳。数据为官方实验室口径,生产环境建议按自有工程实测核对。
装得下,更要讲得清
“过去画布工具的进步,基本等于’能画的节点变多了’。这一版我们想解决的,是’装得下’之后的’讲得清’。”——无限画布产品负责人。
从”能画多少”到”画布顺不顺、流程讲得清”,这次升级把问题往前推了一步。本次升级已于 9 月 1 日全量推送,老用户打开 AI 视频工作台即可使用,新用户注册即用,无需申请内测。